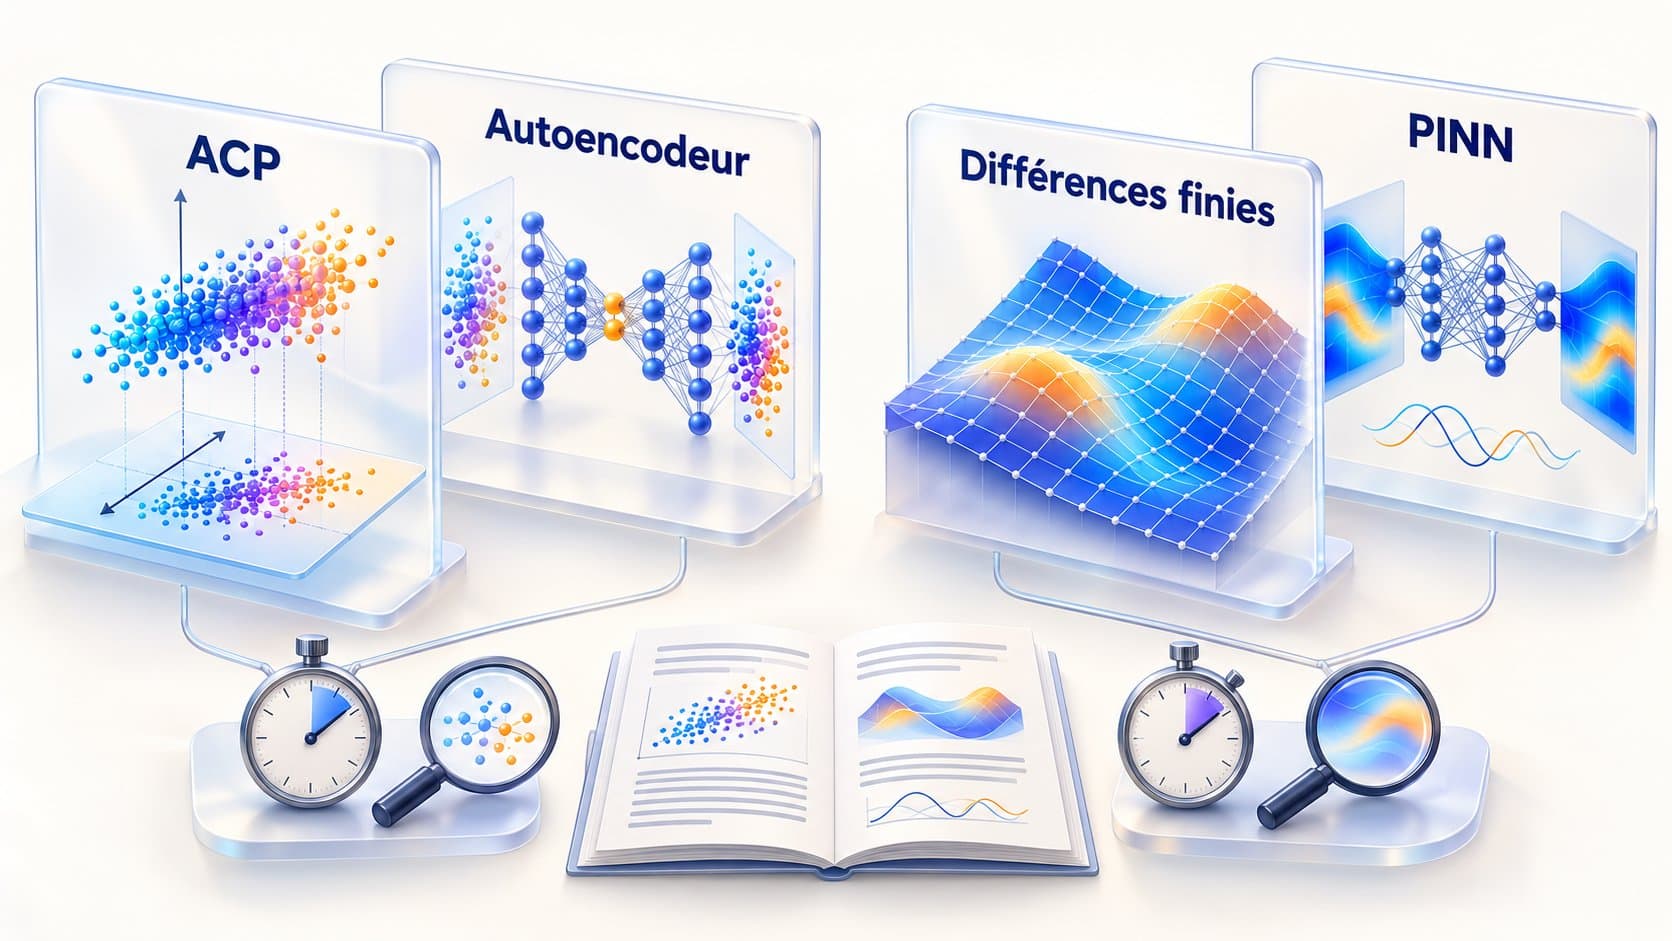
Un autoencodeur, réseau de neurones capable en théorie de repérer des anomalies que l’ACP (analyse en composantes principales) ne voit pas, a fait aussi bien ou moins bien qu’elle dans deux expériences pourtant conçues pour l’avantager. Un réseau de neurones « informé par la physique » (PINN) a perdu d’un facteur dix mille face à une simple grille en 1 dimension, puis a gagné en 5 dimensions. Une revue de la littérature, dans le domaine de la résolution d’équations de la dynamique des fluides par apprentissage automatique, va dans le même sens : 79 % des articles qui annoncent battre une méthode numérique standard la comparent à une référence faible. Voici ce que montrent ces tests, ce qu’ils ne prouvent pas, et comment décider quand le deep learning est vraiment justifié.
La méthode simple d’abord, en un coup d’œil
- Autoencodeur contre ACP : égalité exacte sur le cas facile (F1 de 0,885), léger avantage à l’ACP sur le cas truqué en faveur du réseau (0,318 contre 0,302) [1].
- PINN contre différences finies : en 1 dimension la grille atteint la précision finale du réseau en moins d’une milliseconde ; en 5 dimensions, elle aurait besoin de plus d’un téraoctet de mémoire [2].
- Revue systématique (équations de la dynamique des fluides résolues par apprentissage automatique) : 60 articles sur 76 comparent leur méthode à une référence faible [3].
- Données tabulaires : les modèles à base d’arbres restent à l’état de l’art sur des données de taille moyenne (environ 10 000 échantillons) [4].
- Règle d’usage : battre la référence simple, mesurée honnêtement, avant d’adopter le modèle sophistiqué [7].
Pourquoi commencer par la méthode la plus simple ?
Parce qu’elle fixe ce que le modèle sophistiqué doit réellement battre. Le manuel de prévision de Hyndman et Athanasopoulos pose le principe pour les séries temporelles : les méthodes de référence (la moyenne, la dernière valeur observée, la dernière valeur de la même saison, la tendance moyenne) servent de repères, et « parfois, l’une de ces méthodes simples est la meilleure méthode disponible ». Toute méthode plus élaborée est comparée à elles, et si elle ne les bat pas, elle ne vaut pas qu’on la retienne [7].
Le même réflexe s’applique en dehors des séries temporelles. Dans mon banc d’essai de l’API Decisions, la référence « maison » (une représentation TF-IDF des mots et une régression logistique scikit-learn) servait de point de comparaison à un modèle d’OpenAI. Et dans le test de calibration de Laya, la correction de Platt, une méthode ancienne et simple, corrigeait presque toutes les probabilités mal calibrées. Les trois expériences qui suivent posent la même question à des problèmes très différents : le gain promis par la méthode complexe apparaît-il quand on le mesure ?
Un autoencodeur détecte-t-il mieux les anomalies que l’ACP ?
Pas par défaut. L’argument théorique est propre : l’ACP ne capte que des relations linéaires entre variables, alors qu’un autoencodeur, réseau entraîné à reconstruire sa propre entrée à travers un goulot d’étranglement, peut apprendre des relations non linéaires, et devrait donc repérer des anomalies qui violent une structure non linéaire [1]. La documentation de scikit-learn le confirme côté ACP : elle décompose les données en composantes orthogonales qui expliquent le maximum de variance, et propose une extension non linéaire, l’ACP à noyau [8].
Himanshu Sharma a testé cette affirmation dans un article de Towards Data Science publié le 1er octobre 2026. Données synthétiques (annoncées comme telles), apprentissage sur des échantillons normaux uniquement, évaluation sur un mélange de normaux et d’anomalies. Trois méthodes : un autoencodeur (un MLPRegressor de scikit-learn à goulot de 3 dimensions, couches 8-3-8), l’erreur de reconstruction de l’ACP à 3 composantes (même goulot, pour une comparaison équitable), et une forêt d’isolement comme point de repère non fondé sur la reconstruction [1].
| Expérience | ACP (F1) | Autoencodeur (F1) | Forêt d’isolement (F1) |
|---|---|---|---|
| 1. Cas facile : anomalies à moyenne décalée et variance plus forte | 0,885 | 0,885 | 0,870 |
2. Cas truqué en faveur du réseau : deux variables liées par y = sin(3x) ; les anomalies gardent la bonne plage pour chaque variable mais cassent la relation | 0,318 | 0,302 | 0,091 |
Dans le premier cas, ACP et autoencodeur repèrent toutes les anomalies (rappel de 1,0) et ne diffèrent que par la précision : un décalage de moyenne est un phénomène linéaire, donc la capacité supplémentaire du réseau est inutile. Dans le second, le problème est réellement plus dur pour tout le monde, mais l’ACP passe très légèrement devant, et la forêt d’isolement s’effondre [1].
L’auteur n’en conclut pas que les autoencodeurs sont inutiles. Il conclut qu’un autoencodeur non réglé, avec une architecture par défaut, ne réalise pas automatiquement son avantage théorique. Il avance trois raisons : 700 échantillons d’entraînement, c’est peu pour apprendre une variété non linéaire par descente de gradient, alors que la solution de l’ACP se calcule directement ; l’architecture 8-3-8 est une première hypothèse, pas un modèle réglé ; et l’erreur de reconstruction, moyennée sur toutes les variables, dilue un signal concentré sur quelques-unes [1].
Il propose trois questions avant de choisir un autoencodeur : vos données ont-elles vraiment des relations non linéaires, ou le semblent-elles seulement ? Avez-vous assez de données normales pour qu’un réseau les apprenne ? Avez-vous regardé la distribution des erreurs de reconstruction, quelle que soit la méthode ? Un histogramme tient en une ligne de code et dit tout de suite si les deux classes se recouvrent [1].
Un réseau « informé par la physique » bat-il un solveur classique ?
Cela dépend de la dimension. Samit Ganguly, physicien numérique, a mis un PINN (le réseau reçoit l’équation dans sa fonction de perte et apprend la solution) face à un solveur de différences finies sur l’oscillateur harmonique quantique, un problème dont la réponse exacte est connue, ce qui permet de mesurer l’erreur sans deviner. Il l’a résolu en 1 puis en 5 dimensions. Son article date du 7 octobre 2026 [2].
| Méthode | Temps processeur | Erreur sur l’énergie | Mémoire |
|---|---|---|---|
| 1D : différences finies, 100 points | 0,8 ms | 4,4 × 10⁻⁴ | – |
| 1D : différences finies, 1 600 points | 2,5 ms | 1,8 × 10⁻⁶ | – |
| 1D : PINN (Adam seul) | environ 8 s | environ 10⁻² | – |
| 1D : PINN (Adam puis L-BFGS) | 9 s | 5,7 × 10⁻⁶ | – |
| 5D : différences finies, 16 points par axe | 3,7 s | 5,5 × 10⁻² | 0,3 Go |
| 5D : différences finies pour égaler le PINN (extrapolé, environ 86 points par axe) | – | – | environ 1 400 Go |
| 5D : PINN (Adam puis L-BFGS, environ 9 000 poids) | 89 s | 6,3 × 10⁻⁵ | moins de 0,1 Go |
En 1 dimension, la grille atteint la précision finale du réseau en moins d’une milliseconde, soit environ dix mille fois plus vite, et son erreur baisse de façon prévisible quand on ajoute des points. En 5 dimensions, une grille de 16 points par axe compte déjà un million d’inconnues pour environ 4 % d’erreur ; égaler les 0,1 % du PINN demanderait environ 5 milliards de points. L’auteur résume : « En 1D, la grille gagne d’un facteur dix mille. En 5D, la grille ne peut même pas démarrer » [2].
Les limites sont reconnues par l’auteur lui-même. Ce problème est séparable en cinq problèmes à une dimension : un solveur classique malin, qui exploiterait cette structure, le résoudrait presque exactement en quelques millisecondes. Le PINN a battu un solveur de grille générique, pas toutes les méthodes classiques. Il a aussi reçu de l’aide (un a priori physique, un échantillonnage soigné) sans lesquels il échouait : il avait convergé vers un état excité, et l’optimiseur Adam seul bloquait à quelques pour cent d’erreur, alors qu’ajouter L-BFGS divisait l’erreur par environ 50 [2]. Son conseil : devant un résultat de PINN, se demander ce qu’aurait fait la meilleure méthode classique avec le même calcul.
Ces résultats sont-ils des cas isolés ?
Non, plusieurs travaux publiés vont dans le même sens, avec des nuances.
- Les références faibles dans les articles scientifiques. Nick McGreivy et Ammar Hakim ont passé en revue les articles qui utilisent l’apprentissage automatique pour résoudre des équations aux dérivées partielles de la dynamique des fluides et affirment surpasser une méthode numérique standard : sur 76 articles, 79 % (60 sur 76) comparent à une référence faible. Ils trouvent aussi des signes répandus de biais de publication et de biais de déclaration des résultats, et concluent à un domaine « trop optimiste » [3]. Étude publiée dans Nature Machine Intelligence en octobre 2024 [3].
- Les données tabulaires. Léo Grinsztajn, Edouard Oyallon et Gaël Varoquaux ont comparé réseaux de neurones et modèles à base d’arbres (XGBoost, forêts aléatoires) sur 45 jeux de données variés, en tenant compte de la recherche d’hyperparamètres (20 000 heures de calcul). Leur constat : « les modèles à base d’arbres restent à l’état de l’art sur des données de taille moyenne (environ 10 000 échantillons) » [4].
- Les séries temporelles. Ailing Zeng et ses coauteurs ont montré que de simples modèles linéaires à une couche (LTSF-Linear) « surpassent de façon surprenante les modèles Transformer sophistiqués dans tous les cas » sur neuf jeux de données réels de prévision à long terme, et expliquent que l’attention est insensible à l’ordre, ce qui perd de l’information temporelle [5].
- Les assistants IA et la prévision. Dans le test des quatre pièges, l’algorithme a eu peu d’importance : trois assistants sur quatre ont fini avec un modèle linéaire, et les deux meilleurs avec une régression linéaire ordinaire [6].
Attention, aucune de ces sources ne dit que le deep learning ne sert à rien. Ganguly montre que le PINN devient intéressant en haute dimension et sur des problèmes qui ne se séparent pas ; Grinsztajn et ses coauteurs rappellent que le deep learning a fait progresser le texte et les images [4]. Ce que disent ces sources, c’est que la preuve doit venir de la mesure, pas du prestige du modèle.
Quand le deep learning est-il justifié ?
Quand la méthode simple, mesurée honnêtement, ne suffit pas. Le tableau reprend les conditions évoquées par les sources ci-dessus :
| Situation | Méthode de départ | Le réseau devient intéressant si… |
|---|---|---|
| Détection d’anomalies | ACP, forêt d’isolement | la relation non linéaire est avérée, les données normales sont nombreuses, et le réseau est réglé [1] |
| Équation à résoudre | Différences finies (1 à 3 dimensions) | la dimension est élevée, et le problème ne se sépare pas en sous-problèmes [2] |
| Données tabulaires moyennes | Arbres, forêts aléatoires, boosting | les données sont très volumineuses ou structurées autrement [4] |
| Prévision | Naïve, naïve saisonnière, régression linéaire | le modèle bat la référence avec une MASE nettement inférieure à 1 [7] |
Pour la prévision, la manière de mesurer compte autant que le modèle : je détaille la validation dans pourquoi la MSE ne suffit pas à juger un modèle de prévision.
Comment tester la méthode simple soi-même ?
En quelques lignes. Pour la détection d’anomalies, la référence ACP se limite à l’erreur de reconstruction : on apprend la projection sur les seules données normales, puis on mesure à quel point un nouvel échantillon s’en écarte.
from sklearn.decomposition import PCA

pca = PCA(n_components=3).fit(X_train)          # X_train : données normales uniquement
X_back = pca.inverse_transform(pca.transform(X_test))
erreur = ((X_test - X_back) ** 2).mean(axis=1)  # erreur de reconstruction par échantillon
# Seuil à choisir en regardant l’histogramme de « erreur », comme le recommande l’auteur [1]
Ce n’est qu’une référence : si votre autoencodeur ne la bat pas nettement, avec les mêmes données et le même nombre de dimensions, il ne mérite pas sa complexité. Le test de Laya montre le même geste côté classification : d’abord la correction la plus simple (Platt), ensuite seulement la plus sophistiquée.
Ce que ces tests ne prouvent pas
- Données synthétiques et un seul tirage. L’expérience d’anomalies utilise des données construites pour tester une hypothèse, une seule architecture par défaut, une seule graine aléatoire pour les anomalies. L’auteur précise que la direction du résultat est plus robuste que les chiffres exacts [1].
- Un problème séparable. Le PINN a battu une grille générique, pas une méthode qui exploite la structure du problème. Les temps sont indicatifs : ils dépendent du processeur et de la charge de la machine [2].
- Un domaine particulier pour la revue. Le chiffre de 79 % porte sur l’apprentissage automatique appliqué aux équations de la dynamique des fluides. Il ne dit rien du taux de références faibles en vision ou en langage [3].
Je n’ai rejoué aucune de ces expériences : cet article rapporte et met en regard des études publiées, que j’ai lues à la source, et vérifié les chiffres cités contre ces sources. Les auteurs publient leur code (carnet pour l’expérience d’anomalies, dépôt GitHub pour les PINN) pour qui voudrait reproduire.
Ce qu’il faut retenir
Un modèle sophistiqué ne se justifie que s’il bat une référence simple, mesurée loyalement. Deux expériences récentes le montrent à petite échelle (l’ACP égale ou devance l’autoencodeur ; la grille écrase le PINN en une dimension, puis s’effondre en cinq), et une revue de la littérature le montre à grande échelle : 79 % des articles du domaine étudié comparent à une référence faible. La bonne démarche, quand on apprend la data science : commencer par la méthode simple, la mesurer, et ne passer au modèle complexe que si l’écart est démontré. Et, comme dans le test des quatre pièges de données, ne croire un score que si vous savez comment il a été obtenu.
Ressources pour apprendre
- Formations vidéo : Data Science avec Python et Apprendre la data science avec R, sur Udemy.
- Livre : Python pour la Data Science, aux éditions ENI.
- Le manuel de référence, gratuit : Forecasting: Principles and Practice (Hyndman et Athanasopoulos), en ligne sur otexts.com/fpp3.
- Mesurer avant de choisir : DuckDB face à pandas sur 90 millions de lignes et Polars 2.0 face à pandas 3.0.
Questions fréquentes
Pourquoi commencer par une méthode simple en machine learning ?
Parce qu’elle fixe ce que le modèle sophistiqué doit battre. Le manuel de Hyndman et Athanasopoulos rappelle que parfois l’une des méthodes simples est la meilleure disponible, et qu’une méthode plus élaborée qui ne les bat pas ne vaut pas qu’on la retienne. Sans référence loyale, un gain apparent peut ne venir que d’une comparaison mal posée.
Un autoencodeur est-il meilleur que l’ACP pour détecter des anomalies ?
Pas par défaut. Dans deux expériences synthétiques d’un article de Towards Data Science, l’ACP et un autoencodeur de scikit-learn sont à égalité sur le cas facile (F1 de 0,885) et l’ACP est très légèrement devant sur le cas conçu pour avantager le réseau (0,318 contre 0,302). Un autoencodeur peut faire mieux, à condition d’avoir assez de données et une architecture réglée.
Qu’est-ce qu’un PINN, réseau de neurones informé par la physique ?
C’est un réseau de neurones dont la fonction de perte contient l’équation à résoudre : l’équation joue le rôle d’enseignant et aucune donnée étiquetée n’est nécessaire. Il évalue l’équation en des points tirés au hasard, sans grille. Il n’est pas toujours le meilleur choix : en 1D, un solveur de différences finies le bat d’un facteur dix mille.
Quand un PINN bat-il un solveur classique ?
En haute dimension. Dans le test de Samit Ganguly sur l’oscillateur harmonique, une grille de 16 points par axe en 5D compte un million d’inconnues pour environ 4 % d’erreur, et égaler les 0,1 % du PINN demanderait environ 5 milliards de points et plus d’un téraoctet. Mais le problème était séparable : un solveur classique qui exploite cette structure l’aurait résolu en millisecondes.
Qu’est-ce qu’une référence faible (weak baseline) ?
C’est une méthode de comparaison peu performante ou mal réglée, qui fait paraître la nouvelle méthode meilleure qu’elle n’est. Une revue de McGreivy et Hakim, publiée dans Nature Machine Intelligence en 2024, a trouvé que 79 % (60 sur 76) des articles d’apprentissage automatique pour les équations de la dynamique des fluides qui annoncent battre une méthode standard la comparent à une référence faible.
Les arbres de décision battent-ils encore le deep learning sur les données tabulaires ?
Sur des données de taille moyenne, d’après l’étude de Grinsztajn, Oyallon et Varoquaux : sur 45 jeux de données, avec 20 000 heures de calcul consacrées à la recherche d’hyperparamètres, les modèles à base d’arbres restent à l’état de l’art autour de 10 000 échantillons. Le résultat vaut pour ce régime de taille, pas pour toutes les données.
Les Transformers sont-ils les meilleurs modèles pour prévoir des séries temporelles ?
Pas toujours. Une étude de Zeng et ses coauteurs a montré que de simples modèles linéaires à une couche surpassent des modèles Transformer sophistiqués dans tous les cas testés, sur neuf jeux de données réels de prévision à long terme. Les auteurs expliquent que l’attention est insensible à l’ordre, ce qui fait perdre de l’information temporelle.
Comment savoir si le deep learning se justifie pour mon problème ?
Mesurez d’abord la référence simple avec les mêmes données et le même budget. Passez au réseau si la relation est avérée non linéaire, si vous avez assez de données pour l’apprendre, si la dimension rend les méthodes classiques impraticables, et si l’écart de performance est démontré sur un jeu de test, pas supposé. Regardez aussi la distribution des erreurs, pas seulement le score.
Sources
- Autoencoders vs. PCA: I Rigged the Test and PCA Still WonTowards Data Science (Himanshu Sharma)
Article du 1er octobre 2026, lu en entier dans la copie de la Wayback Machine (le site renvoie un 403 aux robots) : deux expériences synthétiques, 700 échantillons d’entraînement, F1 de 0,885 / 0,885 / 0,870 puis 0,318 (ACP) / 0,302 (autoencodeur) / 0,091 (forêt d’isolement), trois raisons de l’écart avec la théorie et limites reconnues.
- When Do PINNs Beat Classical Numerical Methods? A 1D vs 5D ExperimentTowards Data Science (Samit Ganguly)
Article du 7 octobre 2026, lu en entier dans la copie de la Wayback Machine : oscillateur harmonique quantique en 1D et 5D, temps processeur, erreurs et mémoire des différences finies et du PINN, trois pièges de la version 5D, problème séparable reconnu comme limite, code publié.
- Weak baselines and reporting biases lead to overoptimism in machine learning for fluid-related partial differential equationsNature Machine Intelligence (McGreivy et Hakim)
Revue systématique d’octobre 2024 : 79 % (60 sur 76) des articles qui affirment surpasser une méthode numérique standard comparent à une référence faible ; biais de publication et de déclaration des résultats répandus ; prépublication arXiv 2407.07218 du 9 juillet 2024.
- Why do tree-based models still outperform deep learning on tabular data?arXiv (Grinsztajn, Oyallon, Varoquaux)
Prépublication de juillet 2022 : 45 jeux de données, 20 000 heures de calcul d’hyperparamètres, modèles à base d’arbres à l’état de l’art sur des données de taille moyenne (environ 10 000 échantillons), trois défis pour les réseaux tabulaires.
- Are Transformers Effective for Time Series Forecasting?arXiv (Zeng, Chen, Zhang, Xu)
Prépublication de mai 2022 (révisée en août 2022) : les modèles linéaires LTSF-Linear surpassent les modèles Transformer de prévision à long terme dans tous les cas, sur neuf jeux de données réels ; l’attention, insensible à l’ordre, fait perdre de l’information temporelle.
- I Hid Four Traps in a Forecasting Task. Here Is What Four AI Assistants Did.Towards Data Science (Spyros Georgopoulos)
Article du 6 octobre 2026 : l’algorithme a eu peu d’importance, trois assistants sur quatre ont fini avec un modèle linéaire et les deux meilleurs avec une régression linéaire ordinaire ; ce qui a séparé les réponses est la conception de l’évaluation, les variables retenues et l’examen des erreurs.
- Forecasting: Principles and Practice (3rd ed.) : Some simple forecasting methodsOTexts (Hyndman et Athanasopoulos)
Quatre méthodes de référence (moyenne, naïve, naïve saisonnière, tendance moyenne) comme repères : « parfois, l’une de ces méthodes simples est la meilleure méthode disponible » ; une méthode qui ne les bat pas n’est pas à retenir.
- Decomposing signals in components (matrix factorization problems)scikit-learn (documentation 1.9.1)
L’ACP décompose un jeu de données multivarié en composantes orthogonales qui expliquent le maximum de variance (projection linéaire par décomposition en valeurs singulières) ; l’ACP à noyau en est l’extension non linéaire.
Chiffres et affirmations vérifiés sur ces sources le .