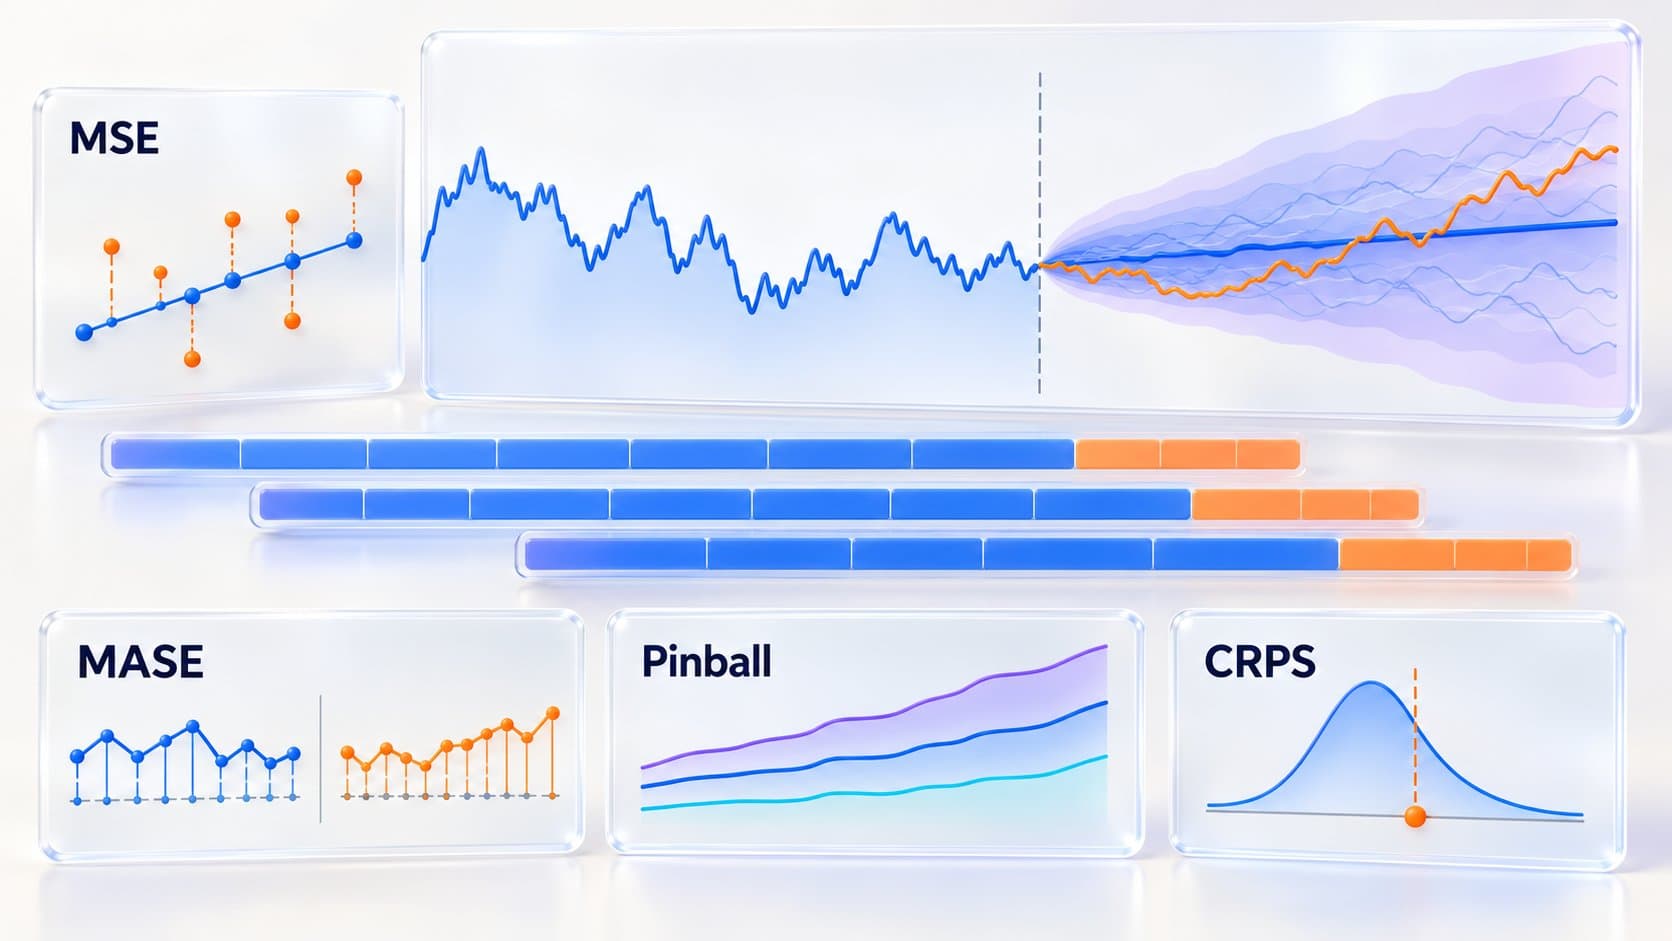
Deux modèles de prévision peuvent afficher la même erreur quadratique moyenne (MSE) à la troisième décimale et décrire des risques très différents. La MSE ne mesure que la distance entre la prévision et la moyenne de ce qui peut arriver : elle ne voit ni la largeur de l’incertitude, ni sa forme. Voici comment évaluer un modèle de prévision pour de bon : découper le temps correctement, choisir une métrique qui compare à une référence simple, mesurer l’incertitude avec la perte « pinball » ou le CRPS, et regarder les prévisions elles-mêmes plutôt qu’un seul chiffre.
L’évaluation d’une prévision en un coup d’œil
- MSE et RMSE récompensent la moyenne de l’avenir ; MAE, sa médiane [2].
- Découpage : toujours entraîner sur le passé et tester sur le futur, avec un « trou » si les données arrivent en retard [3] [5] [6].
- Référence : se comparer à la dernière valeur observée ou à la même saison de l’an passé, avec une erreur mise à l’échelle (MASE) [2] [4].
- Incertitude : un intervalle de prévision s’évalue avec la perte pinball, le score de Winkler ou le CRPS [2] [7].
- Forme : un score peut ne pas voir qu’une prévision place sa probabilité là où le signal ne va jamais [1].
Que cache la MSE dans une prévision ?
La MSE cache l’incertitude. Quand on prédit une quantité aléatoire par un seul nombre et qu’on est pénalisé par l’erreur au carré, le meilleur nombre possible est la moyenne ; un réseau entraîné avec la MSE apprend donc la moyenne conditionnelle de l’avenir, et rien d’autre [1]. Le manuel de Hyndman et Athanasopoulos le dit de façon symétrique : « une méthode de prévision qui minimise la MAE conduit à des prévisions de la médiane, tandis que minimiser la RMSE conduit à des prévisions de la moyenne ».
Waleed Esmail, dans une série d’articles de Towards Data Science intitulée « Your Model’s MSE Is Lying to You », part de ce constat : deux modèles peuvent avoir la même MSE à trois décimales près et un niveau de risque très différent, parce qu’entraîner avec la MSE revient à supposer une cloche gaussienne dont la largeur ne change jamais [1]. La parade de la première partie ajoute une seconde sortie, la variance, entraînée avec la log-vraisemblance gaussienne. La deuxième partie montre que ce correctif se dégrade dès qu’on prévoit plusieurs pas en avant, car réinjecter la moyenne prédite revient à faire comme si toutes les prévisions précédentes étaient parfaites ; on les répare en réinjectant des échantillons et en lançant de nombreux déroulements [1]. La troisième partie, publiée le 8 octobre 2026, s’attaque à la forme de l’incertitude, j’y reviens plus bas.
Comment découper les données pour évaluer une prévision ?
Il faut entraîner sur le passé et tester sur le futur, jamais l’inverse. Dans le cadre de la « validation croisée à origine glissante » décrite par Hyndman et Athanasopoulos, chaque jeu de test est une seule observation et le jeu d’entraînement ne contient que des observations antérieures : « aucune observation future ne peut donc servir à construire la prévision ». La précision est ensuite moyennée sur tous les jeux de test, et les toutes premières observations ne servent jamais de test, faute d’un jeu d’entraînement assez grand pour une prévision fiable [3].
Pourquoi pas la validation croisée habituelle ? Parce que les séries temporelles sont autocorrélées : la documentation de scikit-learn explique que KFold et ShuffleSplit supposent des échantillons indépendants et identiquement distribués, et créeraient une corrélation excessive entre apprentissage et test, d’où de mauvaises estimations de l’erreur de généralisation [5]. La classe TimeSeriesSplit renvoie les k premiers blocs comme jeu d’entraînement et le bloc suivant comme test, et les jeux d’entraînement successifs sont emboîtés les uns dans les autres [5].
Un paramètre mérite d’être connu : gap, le nombre d’échantillons retirés « de la fin de chaque jeu d’entraînement, avant le jeu de test » [6]. Si vos données arrivent avec deux semaines de retard, un gap adapté évite d’entraîner sur des valeurs qui n’existeraient pas encore en production. Ce piège du retard de publication est l’un de ceux que les assistants IA ont le plus souvent traités correctement dans le test des quatre pièges de données, mais le fait de le traiter avec soin ne dispense pas de le vérifier.
Quelle métrique choisir pour un modèle de prévision ?
Aucune ne suffit seule, mais une règle domine : toujours comparer à une référence simple. Le tableau résume ce que récompense chaque mesure d’erreur ponctuelle, d’après le manuel [2] :
| Métrique | Ce qu’elle récompense | À savoir |
|---|---|---|
| MAE | Une prévision proche de la médiane | Facile à comprendre et à calculer ; dépend de l’échelle, donc inutilisable pour comparer des séries dans des unités différentes |
| RMSE | Une prévision proche de la moyenne | Plus difficile à interpréter, malgré un usage très répandu ; pénalise fortement les grosses erreurs |
| MASE | Faire mieux que la prévision « naïve » (la dernière valeur observée, ou la même saison de l’an dernier) | Inférieure à 1 : meilleure que la prévision naïve moyenne sur les données d’entraînement ; comparable entre séries |
| MAPE | Une erreur en pourcentage | Instable près de zéro ; Hyndman et Koehler recommandent de ne pas utiliser la sMAPE |
Les quatre méthodes de référence du manuel sont la moyenne, la dernière valeur observée (« naïve »), la dernière valeur de la même saison, et la tendance moyenne (« drift »). Elles servent de repères plutôt que de choix final, mais « parfois, l’une de ces méthodes simples est la meilleure méthode disponible ». Un modèle qui ne bat pas la prévision naïve ne vaut pas qu’on s’y attarde [4]. C’est aussi le sujet de mon article sur les cas où la méthode simple l’emporte sur le deep learning.
Comment évaluer l’incertitude d’une prévision ?
Avec des scores conçus pour des distributions, pas pour des points. Le premier réflexe est de produire un intervalle plutôt qu’un nombre : avec statsmodels, la méthode get_forecast renvoie un objet de prévision qui contient l’intervalle déjà estimé, alors que forecast ne rend que les points [8] [9]. Un article de KDnuggets du 5 octobre 2026, vérifié avec statsmodels 0.15.0, donne l’exemple suivant, que j’ai relancé tel quel : le résultat est celui de l’article, aux arrondis près [8].
import statsmodels.api as sm
from statsmodels.tsa.arima.model import ARIMA

co2 = sm.datasets.co2.load_pandas().data["co2"]
co2 = co2.resample("MS").mean().ffill()
train, recent = co2[:-12], co2[-12:]
res = ARIMA(train, order=(1, 1, 1), seasonal_order=(1, 1, 1, 12)).fit()
print(res.get_forecast(12).summary_frame().head())
# janvier 2001 : prévision 370,52 ; intervalle de confiance 369,89 – 371,16
Reste à noter un intervalle. Le manuel propose trois outils [2] :
- Le score de quantile, ou perte « pinball » : il se lit comme une erreur absolue et vaut exactement la MAE au quantile 0,5. scikit-learn l’implémente (
mean_pinball_loss) avec un paramètrealpha: à 0,5 c’est la MAE, à 0,95 la perte est minimisée par une estimation du quantile à 95 % [7]. - Le score de Winkler : la longueur de l’intervalle plus une pénalité si l’observation tombe dehors. Un score bas va avec un intervalle étroit [2].
- Le CRPS, moyenne des scores de quantile sur tous les niveaux : « un peu comme une erreur absolue pondérée » calculée sur toute la distribution prévue [2].
Le manuel illustre le CRPS sur le cours de l’action Google : 26,5 pour la méthode naïve, 33,5 pour la tendance moyenne et 76,7 pour la moyenne, ce qui permet de conclure que la méthode naïve fournit de meilleures prévisions distributionnelles que les deux autres [2]. Un score de compétence rapporte une méthode à sa référence : pour la tendance moyenne, −0,266, soit une prévision 26,6 % moins bonne que la naïve [2].
Une bonne moyenne et une bonne variance suffisent-elles ?
Non, et c’est le cœur de la troisième partie d’Esmail. Imaginez une bille posée sur une petite colline entre deux vallées, à −1 et +1. À chaque essai, elle roule dans l’une ou l’autre. Sur mille essais, environ cinq cents finissent près de +1 et cinq cents près de −1, avec une dispersion d’environ 0,1 autour de chaque vallée [1].
Le meilleur modèle gaussien possible annonce alors « autour de 0, à 1 près » : la moyenne est exacte (0) et l’écart-type aussi (environ 1,005). Pourtant sa cloche culmine au sommet de la colline, là où la bille ne va pratiquement jamais, et place environ 38 % de sa probabilité à cet endroit. Moyenne juste, variance juste, et un avenir que le modèle décrit sans qu’il se produise [1]. Comme pour une pièce avant le lancer, la prévision honnête est « pile ou face, à 50-50 », pas « demi-pile ».
Ce que l’expérience a mesuré
L’auteur simule la bille comme une série temporelle, ce qui lui donne la vraie distribution des futurs : il peut relancer le simulateur depuis la dernière mesure autant de fois qu’il veut. Il entraîne deux prévisionnistes identiques à tout point de vue sauf la sortie : une tête gaussienne et une tête de diffusion, qui apprend à transformer du bruit en prévision de la bonne forme. Sur 1 000 contextes de test, il lance 100 trajectoires de 16 pas pour chacun, et pour la vraie physique [1].
| CRPS près de la colline | Part des prévisions sur la colline | |
|---|---|---|
| Vraie physique | 0,485 | 6,6 % |
| Tête gaussienne | 0,494 | 12,8 % |
| Tête de diffusion | 0,493 | 5,8 % |
Les deux têtes sont presque à égalité au CRPS (0,494 contre 0,493), alors que la tête gaussienne place deux fois plus de prévisions sur la colline, où la vraie bille passe moins de 7 % de son temps [1]. La leçon dépasse les modèles de diffusion : un score conçu pour juger des distributions entières ne voit pas une différence de forme. L’auteur en tire cette règle : « chaque fois que vous le pouvez, regardez les échantillons » [1].
Le coût de la méthode, et les limites de l’expérience
Rien n’est gratuit. Une trajectoire de 16 pas demande 800 petits appels de réseau au lieu de 16 ; sur processeur, les déroulements de tous les tests prennent environ une seconde pour la tête gaussienne et une minute et demie pour la tête de diffusion, et l’entraînement dure environ cinq fois plus longtemps [1]. Plus de formule fermée non plus : chaque intervalle ou probabilité de seuil doit être estimé à partir d’échantillons. Côté limites, l’auteur reconnaît des données synthétiques à une dimension, une seule graine aléatoire, des réseaux petits et non réglés, et l’absence de comparaison avec un réseau de mélange de gaussiennes qui traiterait bien ce cas si on lui disait qu’il y a deux bosses [1].
Que faire en pratique pour évaluer une prévision ?
- Découpez dans le temps, avec
TimeSeriesSplitet ungapégal au retard de publication de vos données [5] [6]. - Calculez une référence (naïve, naïve saisonnière) et rapportez la MASE : si vous ne la battez pas, arrêtez-vous là [2] [4].
- Produisez un intervalle et notez-le avec la perte pinball ou le CRPS, pas seulement avec la MAE [2] [7].
- Tracez les prévisions : superposez des trajectoires échantillonnées au réel, comme dans l’expérience de la bille [1].
- Vérifiez la calibration : un intervalle à 80 % doit contenir le réel environ 8 fois sur 10. C’est l’esprit du test de calibration de Laya, appliqué à des probabilités de classes plutôt qu’à des séries.
Je n’ai pas rejoué l’expérience d’Esmail, dont le carnet est publié par l’auteur ; j’ai seulement relancé l’exemple get_forecast de KDnuggets. Les chiffres du CRPS et du « pinball » viennent de la documentation et du manuel cités. Pour un projet réel, la validation doit se faire sur vos données et vos coûts d’erreur : une prévision de stock et une prévision de température n’ont pas la même perte « utile ».
Ce qu’il faut retenir
Un seul chiffre d’erreur résume mal une prévision : la MSE juge une moyenne, la MAE une médiane, et aucune des deux ne juge l’incertitude. Découpez le temps sans fuite, comparez à une référence simple, notez vos intervalles avec la perte pinball ou le CRPS, et regardez des trajectoires échantillonnées. C’est le même esprit que dans mon test sur les quatre pièges de données qu’un assistant IA peut laisser passer : un score n’a de sens que si vous savez ce qu’il mesure.
Ressources pour apprendre
- Formations vidéo : Data Science avec Python et Apprendre la data science avec R, sur Udemy.
- Livre : Python pour la Data Science, aux éditions ENI.
- Le manuel de référence, gratuit : Forecasting: Principles and Practice (Hyndman et Athanasopoulos), en ligne sur otexts.com/fpp3.
- Les données, d’abord : Polars 2.0 face à pandas 3.0 et DuckDB pour analyser de gros volumes sans serveur.
Questions fréquentes
Que mesure vraiment la MSE dans une prévision ?
La distance entre la prévision et la moyenne de ce qui peut arriver. Entraîner un modèle avec la MSE revient à lui faire apprendre la moyenne conditionnelle de l’avenir et, implicitement, une cloche gaussienne dont la largeur ne change jamais. La MSE ne dit rien de l’incertitude : deux modèles peuvent avoir la même MSE et des niveaux de risque très différents.
Quelle différence entre MAE et RMSE ?
Minimiser la MAE conduit à prévoir la médiane, minimiser la RMSE à prévoir la moyenne. La MAE est facile à comprendre et à calculer ; la RMSE pénalise davantage les grosses erreurs et s’interprète moins facilement. Toutes deux dépendent de l’échelle : on ne les compare pas entre des séries d’unités différentes.
Pourquoi la validation croisée classique ne convient-elle pas aux séries temporelles ?
Parce que KFold et ShuffleSplit supposent des échantillons indépendants et identiquement distribués, alors que les observations proches dans le temps sont autocorrélées. Elles créent une corrélation excessive entre entraînement et test et donnent de mauvaises estimations de l’erreur. TimeSeriesSplit entraîne sur le passé et teste sur le futur, avec des jeux d’entraînement emboîtés.
À quoi sert le paramètre gap de TimeSeriesSplit ?
Il retire un nombre fixé d’échantillons de la fin de chaque jeu d’entraînement, avant le jeu de test. Si vos données sont publiées avec deux semaines de retard, un gap adapté évite d’entraîner le modèle sur des valeurs qui n’existeraient pas encore au moment réel de la prévision.
Qu’est-ce que la MASE et pourquoi l’utiliser ?
C’est l’erreur absolue moyenne divisée par celle d’une prévision naïve (la dernière valeur observée, ou la même saison de l’année précédente) sur les données d’entraînement. Une valeur inférieure à 1 signifie que le modèle fait mieux que la prévision naïve moyenne. Elle permet de comparer des séries d’échelles différentes et force à se comparer à une référence simple.
Comment évaluer un intervalle de prévision ?
Avec des scores de distribution : la perte pinball (score de quantile), qui équivaut à la MAE au quantile 0,5, le score de Winkler, qui additionne la longueur de l’intervalle et une pénalité en cas de sortie, et le CRPS, moyenne des scores de quantile. scikit-learn propose mean_pinball_loss ; le CRPS se calcule à partir des échantillons ou des quantiles de la prévision.
Un modèle peut-il avoir la bonne moyenne et la bonne variance et se tromper de forme ?
Oui. Pour une bille qui retombe soit à −1 soit à +1, le meilleur modèle gaussien annonce « autour de 0, à 1 près » : moyenne et variance exactes, mais environ 38 % de sa probabilité sur une zone où la bille ne va pratiquement jamais. Au CRPS, ce modèle (0,494) est presque à égalité avec un modèle qui reproduit les deux bosses (0,493) ; seul le tracé des échantillons montre la différence.
Faut-il toujours utiliser un modèle de diffusion pour prévoir ?
Non. Dans l’expérience de l’article, la tête de diffusion reproduit la bonne forme mais coûte environ cinq fois plus cher à entraîner, 800 appels de réseau au lieu de 16 par trajectoire, et ne donne plus de formule fermée pour les intervalles. L’expérience est synthétique, à une dimension, avec une seule graine. Une référence simple et un bon découpage du temps passent avant.
Sources
- Your Model’s MSE Is Lying to You III: Time Series DiffusionTowards Data Science (Waleed Esmail)
Article du 8 octobre 2026, lu en entier dans la copie de la Wayback Machine (le site renvoie un 403 aux robots) : MSE et moyenne conditionnelle, tête gaussienne contre tête de diffusion sur un signal à deux puits, CRPS de 0,494 contre 0,493, part des prévisions sur la barrière (12,8 % contre 5,8 %, vérité 6,6 %), coûts et limites.
- Forecasting: Principles and Practice (3rd ed.) : Evaluating forecast accuracyOTexts (Hyndman et Athanasopoulos)
MAE et RMSE (médiane contre moyenne), MASE, score de quantile (« pinball »), score de Winkler, CRPS et score de compétence, avec l’exemple de l’action Google (CRPS de 26,5 pour la naïve, 33,5 pour la tendance moyenne, 76,7 pour la moyenne).
- Forecasting: Principles and Practice (3rd ed.) : Time series cross-validationOTexts (Hyndman et Athanasopoulos)
Validation croisée à origine glissante : chaque jeu de test est une observation, le jeu d’entraînement ne contient que des observations antérieures, et les toutes premières observations ne servent jamais de test.
- Forecasting: Principles and Practice (3rd ed.) : Some simple forecasting methodsOTexts (Hyndman et Athanasopoulos)
Quatre méthodes de référence (moyenne, naïve, naïve saisonnière, tendance moyenne) ; une méthode qui ne les bat pas ne vaut pas qu’on la retienne.
- Cross-validation: evaluating estimator performance : Cross validation of time series datascikit-learn (documentation 1.9.1)
Autocorrélation des séries temporelles, limites de KFold et ShuffleSplit (échantillons indépendants et identiquement distribués), TimeSeriesSplit et jeux d’entraînement emboîtés.
- sklearn.model_selection.TimeSeriesSplitscikit-learn (documentation 1.9.1)
Paramètres n_splits, test_size et gap (« nombre d’échantillons à exclure de la fin de chaque jeu d’entraînement avant le jeu de test », ajouté en 0.24).
- sklearn.metrics.mean_pinball_lossscikit-learn (documentation 1.9.1)
Perte pinball pour la régression quantile : le paramètre alpha vaut 0,5 par défaut (équivalent à la MAE), et la perte est minimisée par l’estimateur du quantile alpha (0,95 pour le quantile à 95 %).
- 3 Statsmodels Tricks for Time Series Analysis & ForecastingKDnuggets (Matthew Mayo)
Article du 5 octobre 2026, vérifié par l’auteur avec statsmodels 0.15.0 : get_forecast renvoie les points et l’intervalle déjà estimé (predicted_mean, conf_int, summary_frame) ; exemple relancé pour cet article.
- statsmodels : MLEResults.get_forecaststatsmodels (documentation 0.15.0)
get_forecast renvoie un objet PredictionResults contenant des prévisions hors échantillon et des intervalles de confiance, contrairement à forecast, qui ne renvoie que les prévisions.
Chiffres et affirmations vérifiés sur ces sources le .