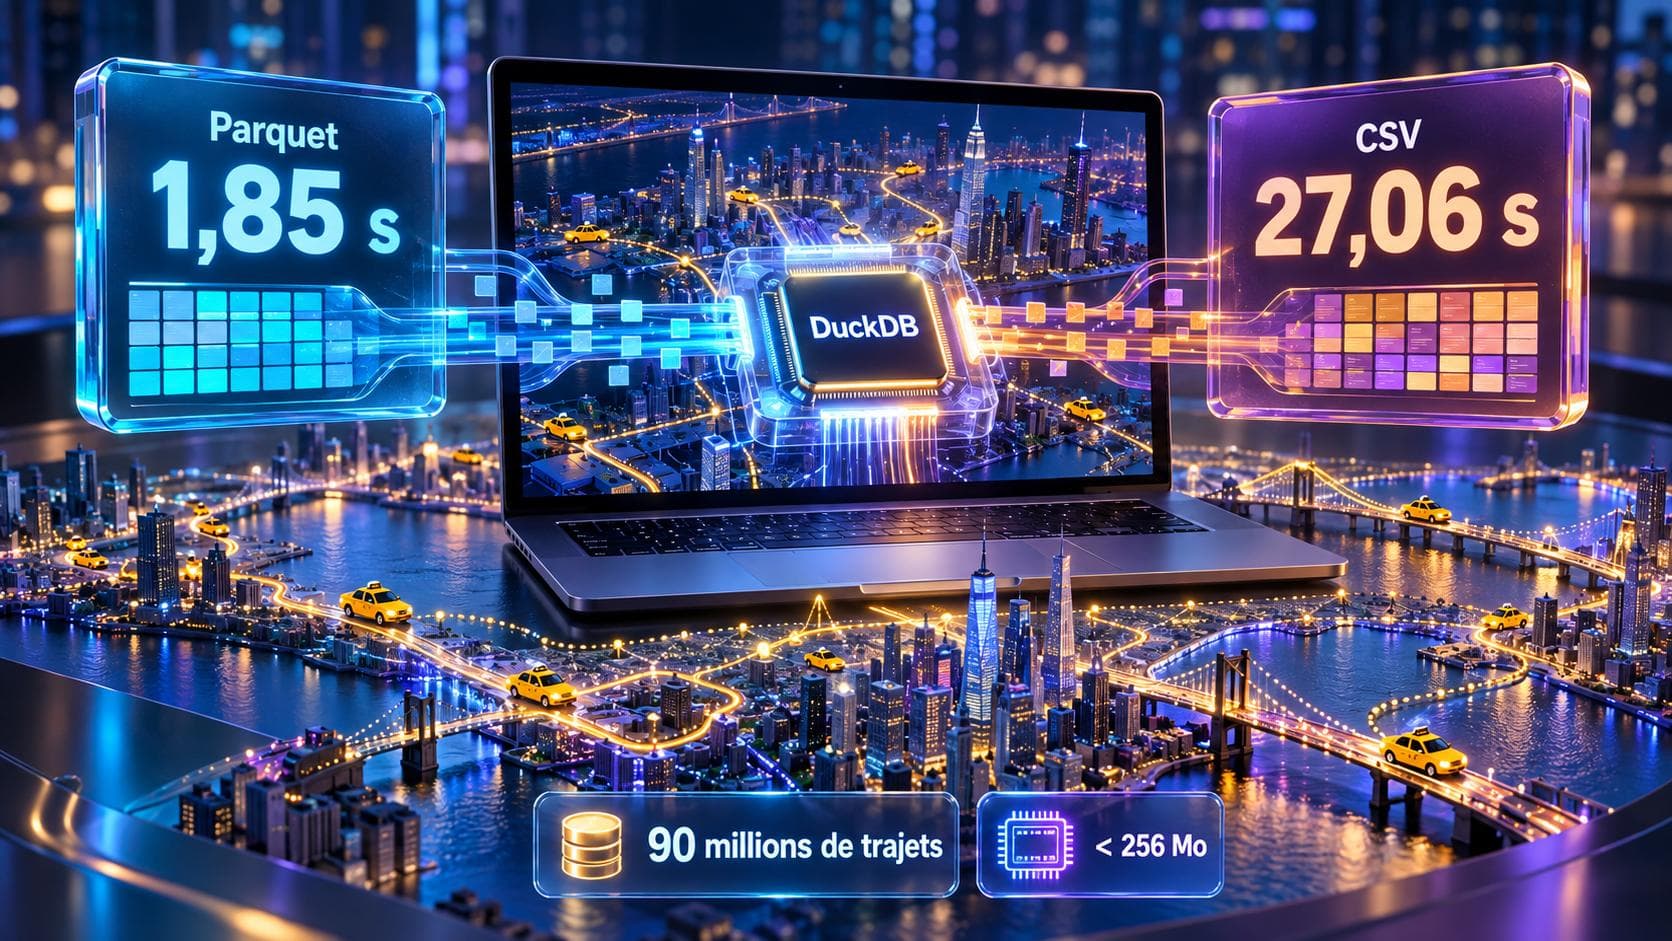
90 millions de trajets de taxi new-yorkais — 8,4 Go de CSV, 1,5 Go de Parquet — analysés sur une VM à 4 cœurs, sans base de données, sans serveur à installer, sans compte à créer. Sous une limite de mémoire de 256 Mo, DuckDB répond en 11,6 secondes en débordant 1,6 Go sur le disque. Sur le même matériel et les mêmes données, une lecture complète avec pandas s'arrête au bout de 30 secondes. Voici le protocole, les chiffres bruts, et ce qu'ils ne prouvent pas.
La veille technologique de ce blog a fait remonter huit billets DuckDB en une semaine — la version 1.5.6 [1], une base persistante dans le navigateur [2], une intégration avec Hugging Face [3], un adaptateur embarqué dans dbt [4]. La promesse revient chaque fois : interroger des volumes importants « sans serveur ». C'est une affirmation vérifiable, alors je l'ai vérifiée.
Pourquoi ce test
« Sans serveur » ne veut pas dire « sans capacité ». Un moteur embarqué n'a pas de processus à administrer, mais il tourne dans la mémoire de votre machine — et c'est justement là que les choses se corsent quand le fichier dépasse la RAM disponible. La question qui compte n'est donc pas « est-ce que ça marche ? », mais « jusqu'où ça tient quand ça ne tient plus ? ».
DuckDB répond à cette question par une architecture particulière : il peut traiter des données plus grosses que la mémoire allouée en les faisant déborder sur le disque, dans un répertoire temporaire. C'est ce comportement précis que ce test mesure — pas une comparaison abstraite de moteurs, mais le point de rupture.
Le protocole
Pour que les chiffres veuillent dire quelque chose, il faut dire exactement sur quoi ils ont été obtenus.
| Élément | Valeur |
|---|---|
| Machine | VM Linux, 4 vCPU, 7,6 GiB de RAM |
| Moteur | DuckDB CLI v1.5.6 (« Variegata ») |
| Comparaison Python | pandas 3.0.6 sur Python 3.12.14 |
| Parallélisme | threads=2 — deux cœurs sur quatre, pour ne pas saturer la machine |
| Jeu de données | NYC TLC Yellow Taxi Trip Records, 24 mois (2024-01 → 2025-12) |
| Volume | 89 892 322 lignes, 19 colonnes |
| Formats | Parquet d'origine : 1,5 Go · CSV dérivé : 8,38 Go |
| Répétitions | 3 exécutions par mesure, médiane reportée |
Le jeu de données est public : les trajets de taxis jaunes de New York, publiés mois par mois par la commission des taxis de la ville [5]. Chaque enregistrement contient les horodatages de prise en charge et de dépose, les zones de départ et d'arrivée, la distance, le tarif, le pourboire et le mode de paiement. C'est un vrai jeu de données métier, pas un jeu synthétique — et il se comporte comme tel, j'y reviens.
Une précision sur le CSV
La TLC ne sert plus les fichiers CSV : les URL correspondantes répondent en HTTP 403, en HEAD comme en requête partielle [5]. Le CSV de ce test a donc été produit à partir du Parquet par DuckDB lui-même, en une commande, sur les mêmes lignes. Ce n'est pas un fichier officiel, c'est une conversion contrôlée — et le rapport de taille qu'on en tire (×5,6) est celui d'une conversion DuckDB, pas nécessairement celui qu'obtiendrait un autre outil.
Conseil de pro — Reproduisez toujours la conversion vous-même avant de comparer deux formats. Un ratio « CSV contre Parquet » dépend autant de l'outil qui écrit que du format lui-même : nombre de décimales écrites, guillemets, encodage.
Résultat 1 : compter 90 millions de lignes
Première opération, la plus simple : compter les lignes. C'est là qu'apparaît la première différence structurelle entre les deux formats.
| Format | Temps | Mémoire | Octets lus |
|---|---|---|---|
| Parquet | 0,03 s | 27 Mo | 0 Mo |
| CSV | 20,17 s | 155 Mo | 8 310 Mo |
Le chiffre du Parquet n'est pas une victoire de vitesse : c'est une absence de lecture. Un fichier Parquet stocke, dans ses métadonnées, le nombre de lignes de chaque groupe de données. DuckDB répond donc à la question sans ouvrir le contenu. Le CSV, lui, n'a aucune métadonnée : pour compter, il faut tout lire.
Autrement dit, ces deux lignes ne mesurent pas la même chose, et il serait malhonnête d'en tirer un « 670 fois plus rapide ». Ce que le tableau établit, c'est autre chose, et c'est plus intéressant : certaines questions ne coûtent rien en Parquet et coûtent une lecture complète en CSV. Encore faut-il que la question soit de celles-là.
Résultat 2 : une vraie requête analytique
Passons à une question qu'un analyste pose réellement : à quelle heure de la journée se paient les plus longs trajets, et dans quel arrondissement ? Elle agrège 90 millions de lignes par heure et par arrondissement, après une jointure avec la table de correspondance des 265 zones de taxi [6].
SELECT CAST(date_part('hour', t.tpep_pickup_datetime) AS INTEGER) AS heure,
       z.Borough AS arrondissement,
       count(*) AS trajets,
       round(avg(t.trip_distance), 2) AS distance_moy
FROM read_parquet('yellow_tripdata_*.parquet') t
JOIN read_csv_auto('taxi_zone_lookup.csv') z
  ON t.PULocationID = z.LocationID
WHERE t.tpep_pickup_datetime >= TIMESTAMP '2024-01-01'
  AND t.tpep_pickup_datetime <  TIMESTAMP '2025-01-01'
GROUP BY 1, 2 ORDER BY 1, 2;| Format | Temps (médiane) | Mémoire | Octets lus |
|---|---|---|---|
| Parquet | 1,85 s | 67 Mo | 557 Mo au premier passage, ~0 ensuite |
| CSV | 27,06 s | 164 Mo | 8 244 Mo à chaque passage |
Deux choses se lisent dans ce tableau, et la seconde est la plus révélatrice.
D'abord le rapport : 14,6 fois plus rapide en Parquet. Ensuite, la colonne des octets lus. Sur Parquet, le premier passage lit 557 Mo — la fraction réellement utile des 1,5 Go — puis zéro, parce que ces colonnes tiennent dans le cache du système. Le CSV, lui, relit 8,2 Go à chaque exécution : à 8,4 Go, le fichier ne rentre tout simplement pas dans les 4 Go de mémoire libre de la machine, donc aucun cache ne l'absorbe. Le CSV ne paie pas la conversion une fois, il la paie à chaque requête.
Exemple concret — Sur un poste de travail, cette différence est celle entre une requête qu'on relance pour ajuster un filtre et une requête qu'on lance puis qu'on va chercher un café. La première invite à explorer, la seconde décourage.
Et sur une agrégation complète
Pour écarter tout effet de bord lié aux métadonnées, j'ai refait le test avec une agrégation qui force la lecture de toutes les colonnes utiles, sans filtre : nombre de lignes, recette totale, distance moyenne, dernier horodatage. Les deux formats renvoient exactement le même résultat.
| Format | À froid | À chaud | Mémoire |
|---|---|---|---|
| Parquet | 1,88 s | 1,35 s | 51 Mo |
| CSV | 25,47 s | 25,01 s | 155 Mo |
18,6 fois plus rapide à chaud, et surtout : le Parquet reste à 51 Mo de mémoire pour parcourir 90 millions de lignes. Il ne charge rien, il fait passer les données.
Résultat 3 : le test qui porte l'article
Voilà le cœur du sujet. J'ai fixé la limite de mémoire de DuckDB à 256 Mo — moins de la moitié du fichier Parquet, et 3 % du CSV — puis relancé une agrégation plus lourde, groupée par jour, heure, zone de départ, zone d'arrivée et mode de paiement, sur les 24 mois.
SET threads=2;
SET memory_limit='256MB';
SET temp_directory='/chemin/vers/un/disque/rapide';

SELECT tpep_pickup_datetime::DATE AS jour,
       CAST(date_part('hour', tpep_pickup_datetime) AS INTEGER) AS heure,
       PULocationID, DOLocationID, payment_type,
       count(*) AS trajets
FROM read_parquet('yellow_tripdata_*.parquet')
GROUP BY 1,2,3,4,5 ORDER BY trajets DESC LIMIT 10;| Mesure | Valeur |
|---|---|
| Résultat | Requête terminée, top 10 renvoyé |
| Temps (médiane) | 11,60 s |
| Mémoire au pic | 317 Mo (limite fixée : 256 Mo) |
| Écrit sur disque | 1 632 Mo dans le répertoire temporaire |
DuckDB a donc traité 90 millions de lignes en n'ayant le droit d'utiliser que 256 Mo de mémoire, en écrivant 1,6 Go sur le disque pour compenser. Il n'a pas accéléré, il n'a pas optimisé : il a fait ce qu'un moteur de base de données fait quand la mémoire manque — il a débordé sur le disque, proprement, et il a rendu son résultat.
C'est très exactement ce que « sans serveur » veut dire quand c'est vrai : pas « sans contrainte », mais la contrainte est gérée par le moteur au lieu d'être renvoyée à l'utilisateur·rice.
Astuce — Placez toujours
temp_directorysur un disque rapide, idéalement un SSD local. Dans ce test, 1,6 Go ont transité par ce répertoire en une dizaine de secondes : c'est lui qui décide de la vitesse à laquelle le moteur encaisse le débordement.
Résultat 4 : face au shell, puis face à pandas
Le shell
Avant DuckDB, comment faisait-on sans base de données ? Avec les outils du système. La même question — compter les trajets par heure — s'écrit en une ligne d'awk et un tri.
awk -F, 'NR>1 {c[substr($2,12,2)]++} END {for (h in c) print h, c[h]}' \
yellow_taxi_2024_2025.csv | sort -k2 -rn| Approche | Temps (médiane) | Mémoire |
|---|---|---|
awk + sort | 75,90 s | 8 Mo |
| DuckDB sur le même CSV | 25,01 s | 155 Mo |
Le shell n'est pas ridicule, et il faut le dire : il tient en 8 Mo de mémoire, soit vingt fois moins que DuckDB. Il est simplement trois fois plus lent sur cette question — et surtout, il ne sait faire que celle-là. Dès qu'il faut une jointure, un regroupement à plusieurs niveaux ou un calcul de moyenne pondérée, la ligne d'awk devient un programme, et c'est là que l'écart cesse d'être une question de vitesse.
pandas
C'est la comparaison qui compte le plus, parce que c'est l'outil que la plupart des lectrices et lecteurs utilisent déjà. Deux exécutions, sur le même CSV de 8,4 Go [7].
| Mode | Résultat | Temps | Mémoire au pic |
|---|---|---|---|
| Par blocs de 5 millions de lignes | Terminé — 89 892 322 lignes | 167,7 s | 3 035 Mo |
| Lecture complète, plafond de 3,8 Go | Arrêt brutal (SIGSEGV) au bout de 30 s | 29,7 s | 3 726 Mo |
La lecture par blocs fonctionne : c'est même la bonne façon de faire avec pandas, et elle donne le résultat. Mais elle demande 3 Go de mémoire pour des blocs de 5 millions de lignes, soit douze fois la limite imposée à DuckDB — et elle est 6,7 fois plus lente que DuckDB sur les mêmes données, tout en ne faisant qu'un comptage.
La lecture complète, elle, ne produit ni résultat ni message d'erreur exploitable : le processus s'arrête. Il faut préciser honnêtement que cet arrêt survient sous un plafond de mémoire que j'ai imposé (3,8 Go) ; sans ce plafond, pandas aurait continué à allouer jusqu'à ce que la machine le tue. Dans les deux cas, il n'y a pas de plan B : pandas n'a pas de mécanisme de débordement sur disque. Quand la mémoire manque, il n'y a pas de repli, il n'y a qu'un arrêt.
Conseil de pro — Si vos données tiennent en mémoire, pandas reste parfaitement adapté et son écosystème est irremplaçable. Le problème commence au moment précis où le fichier dépasse la RAM — et c'est ce moment-là qu'il faut anticiper, pas découvrir.
Ce que ce test prouve, et ce qu'il ne prouve pas
Commençons par ce que ces chiffres prouvent, sur cette machine et sur ces données :
- DuckDB traite 90 millions de lignes et 8,4 Go de CSV sans serveur, sans installation, sans compte.
- Sous une limite de 256 Mo, il termine une agrégation lourde en débordant 1,6 Go sur le disque — le repli fonctionne.
- Le format Parquet change la donne au-delà de la vitesse : certaines questions deviennent gratuites, et le fichier reste dans le cache système là où le CSV ne rentre pas.
- Face à pandas, l'écart n'est pas seulement de vitesse : il est de comportement en cas de manque de mémoire.
Et maintenant les limites, qui sont nombreuses :
- Une seule machine, un seul jeu de données. Une VM à 4 cœurs et un fichier de trajets de taxi. Les rapports de vitesse ne se transposent ni à un autre matériel, ni à une autre forme de données. Un jeu à colonnes très larges ou très textuelles se comporterait autrement.
- Le cache fausse les comparaisons. À partir de la deuxième exécution, le système garde en mémoire ce qu'il vient de lire. Je le signale dans les tableaux (« à froid » contre « à chaud »), mais un test « à froid » véritable exigerait de vider le cache système — ce qui n'est pas possible ici.
- Le CSV n'est pas un fichier officiel. Il a été produit par DuckDB à partir du Parquet [5] : le ratio de taille et le temps de lecture dépendent d'abord de la façon dont DuckDB écrit le CSV.
- Le test pandas est limité par un plafond que j'ai posé. Le chiffre de 3 Go pour la lecture par blocs est une mesure ; la quantité de mémoire qu'aurait demandée une lecture complète sans limite n'est pas mesurée, seulement contournée par le plafond.
- Aucune comparaison à un vrai entrepôt de données. Ce test ne dit pas si DuckDB remplace un entrepôt analytique sur un volume industriel, ni comment il se comporte à plusieurs utilisateurs simultanés. Ce n'est pas la question posée ici.
- Rien de comparable aux chiffres publiés par l'éditeur. Le billet de la 1.5.6 publie lui-même un TPC-H au facteur d'échelle 300, sur une machine à 128 Go de RAM et 12 cœurs : 822 secondes en 1.5.6 contre 129 secondes en 2.0.0-dev, soit « more than 6× faster », avec cette réserve explicite de l'auteur qu'un tel facteur ne se généralise pas [1]. Mes chiffres portent sur une machine vingt fois moins dotée et un autre jeu de données : ils ne se comparent pas aux siens.
- 59 lignes sur 89 892 322 sortent de la période couverte — 0,0001 %. Les fichiers vont de janvier 2024 à décembre 2025, mais une prise en charge remonte au 31 décembre 2002 et une dépose au 27 juin 2026. Une proportion infime, et pourtant suffisante pour casser un filtre par date écrit à la légère. Ce test ne les a pas nettoyées : les agrégations présentées ici les incluent.
Reproduire ce test
Tout est reproductible sans compte ni service. Le binaire DuckDB se télécharge en une commande [8].
# 1. Le moteur (archive .gz : le binaire se décompresse, rien à installer)
curl -sSL -o duckdb.gz \
  https://github.com/duckdb/duckdb/releases/download/v1.5.6/duckdb_cli-linux-amd64.gz
gunzip -c duckdb.gz > duckdb && chmod +x duckdb

# 2. Les données (24 fichiers Parquet + la table des zones)
for y in 2024 2025; do for m in 01 02 03 04 05 06 07 08 09 10 11 12; do
  curl -sSLO "https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_$y-$m.parquet"
done; done
curl -sSLO "https://d37ci6vzurychx.cloudfront.net/misc/taxi_zone_lookup.csv"

# 3. Le CSV dérivé (la TLC ne le sert plus : HTTP 403)
./duckdb -c "COPY (SELECT * FROM read_parquet('yellow_tripdata_*.parquet'))
             TO 'yellow_taxi.csv' (FORMAT csv, HEADER);"
Toutes les mesures de cet article ont été prises le 1er octobre 2026, avec DuckDB v1.5.6 et pandas 3.0.6, sur la machine décrite plus haut. Le CSV complet a été supprimé après le test.
Ressources pour apprendre
- Formations vidéo : Data Science avec Python et Apprendre la data science avec R, sur Udemy.
- Livre : Python pour la Data Science, aux éditions ENI.
- Les formats de fichiers : Polars 2.0 face à pandas 3.0, où le même sujet du format et du moteur est traité côté DataFrame.
- Le reste de l'outillage : la partie outillage de mon article sur les erreurs fréquentes, pour figer un environnement reproductible.
- Pour structurer son apprentissage : la roadmap data science, du niveau débutant au niveau professionnel.
Questions fréquentes
Qu'est-ce que DuckDB ?
Un moteur de base de données analytique qui s'exécute dans votre processus, sans serveur à installer ni service à administrer. On l'utilise depuis la ligne de commande, depuis Python, R, Java ou dans un navigateur. Il lit directement les fichiers CSV, Parquet, JSON et bien d'autres, sans étape d'import préalable : la requête porte sur les fichiers eux-mêmes.
Que veut dire « analyser des Go de données sans serveur » ?
Qu'on interroge un gros volume de données sur sa propre machine, sans base de données à provisionner ni entrepôt distant. La conséquence pratique est double : pas de coût d'infrastructure ni d'administration, mais aussi aucune mémoire supplémentaire disponible — le moteur travaille avec la RAM du poste. C'est précisément ce qui rend la question du débordement sur disque décisive.
DuckDB peut-il traiter un fichier plus gros que la mémoire disponible ?
Oui, et c'est mesuré ici. Avec une limite fixée à 256 Mo de mémoire, DuckDB a terminé une agrégation sur 90 millions de lignes en 11,6 secondes, en écrivant 1 632 Mo dans son répertoire temporaire. Il ne s'agit pas d'une accélération : le moteur ralentit et déborde sur le disque, mais il rend son résultat au lieu d'échouer. La vitesse du disque qui héberge ce répertoire détermine alors l'essentiel du temps d'exécution.
Pourquoi le Parquet est-il plus rapide que le CSV ?
Pour trois raisons cumulatives, toutes mesurées ici. Le Parquet est un format colonne : une requête qui n'utilise que 4 colonnes sur 19 ne lit que celles-là. Il est compressé et stocké par blocs, donc beaucoup plus petit (1,5 Go contre 8,4 Go pour les mêmes 90 millions de lignes). Et il embarque des métadonnées : compter les lignes prend 0,03 seconde, sans lire un seul octet de données, là où le CSV doit être parcouru en entier.
Faut-il abandonner pandas pour DuckDB ?
Non, et ce n'est pas la conclusion de ce test. Si vos données tiennent en mémoire, pandas reste adapté et son écosystème est irremplaçable. La différence mesurée est ailleurs : pandas n'a aucun mécanisme de débordement sur disque. Quand la mémoire manque, DuckDB ralentit et continue, pandas s'arrête. Le bon réflexe est de connaître la taille au-delà de laquelle on bascule, pas de choisir un camp.
Combien de mémoire faut-il pour analyser 8 Go de CSV avec pandas ?
Sur ce test, lire le CSV de 8,4 Go par blocs de 5 millions de lignes a demandé 3 035 Mo de mémoire au pic, pour un comptage complet en 167,7 secondes. La lecture du fichier entier d'un seul coup n'a produit aucun résultat : le processus s'est arrêté après 30 secondes, sous un plafond de 3,8 Go. Retenez surtout le rapport : la mémoire nécessaire dépasse largement la taille du fichier sur disque.
DuckDB remplace-t-il les outils shell comme awk et sort ?
Il les complète plus qu'il ne les remplace. Sur cette mesure, awk et sort ont compté les trajets par heure en 75,9 secondes contre 25 secondes pour DuckDB sur le même CSV, mais avec 8 Mo de mémoire contre 155 Mo. Le shell reste imbattable en frugalité et suffisant pour un filtre sur un fichier raisonnable. Il atteint ses limites dès qu'il faut joindre deux sources ou enchaîner plusieurs regroupements.
Les chiffres de cet article sont-ils transposables à une autre machine ?
Non, et l'article le dit explicitement. Ils portent sur une VM à 4 cœurs avec 7,6 GiB de RAM, un seul jeu de données et un CSV produit par DuckDB lui-même. Les rapports de vitesse varient avec le matériel, la forme des colonnes et l'état du cache système. Ce qui se transpose, c'est la propriété qualitative : le débordement sur disque fonctionne, et le format colonne change la nature des questions qu'on peut poser gratuitement.
Sources
- Announcing DuckDB 1.5.6DuckDB
Notes de version du 28 septembre 2026 (sixième correctif de la branche 1.5 « Variegata ») : corrections, améliorations de performance et correctifs de sécurité, dont le nouveau réglage « enable_optimistic_write » et un durcissement de la lecture des fichiers temporaires. Le billet publie aussi un TPC-H au facteur d'échelle 300 (822 s en 1.5.6 contre 129 s en 2.0.0-dev, « more than 6× faster »), assorti de la réserve de l'auteur : « please do not expect a 6× speedup to generalize to all workloads ».
- Persistent Databases in the Browser with DuckDB-Wasm and OPFSDuckDB
Billet du 18 septembre 2026 : DuckDB-Wasm peut ouvrir une base à un chemin opfs:// qui survit au rechargement de la page et au redémarrage du navigateur, là où les données vivaient auparavant dans la mémoire du worker. Signale au passage une version npm « latest » cassée qui crée les fichiers OPFS sans jamais y écrire, et rappelle que le stockage navigateur peut être évincé : « Treat OPFS as a fast local cache ».
- DuckDB and Hugging Face: Querying Datasets DirectlyDuckDB
Billet du 25 septembre 2026 : le schéma de chemin hf:// permet d'interroger un jeu de données du Hub directement depuis un SELECT, sans téléchargement préalable ni serveur à lancer — « no download step and no server to run ». Les fichiers ne sont lus que sur les colonnes demandées, et la branche ~parquet expose automatiquement une version colonne de chaque jeu de données.
- DuckDB Now Ships inside dbt v2DuckDB
Billet du 22 septembre 2026 : dbt 2.0, construit sur le moteur Fusion, embarque un adaptateur DuckDB intégré et rend caduc le paquet Python dbt-duckdb (« needs no separate install »). dbt télécharge et met en cache le pilote DuckDB tout seul ; les métadonnées du projet sont désormais stockées en Parquet et donc interrogeables directement.
- Yellow Taxi Trip Records — fichiers Parquet mensuelsNYC Taxi & Limousine Commission
Source du jeu de données testé : un fichier Parquet par mois (même URL en remplaçant 2024-01 par les 23 autres mois de 2024 et 2025). Les fichiers CSV correspondants ne sont plus servis : mesuré en HTTP 403 sur les méthodes HEAD et GET. Le site nyc.gov qui les documente refuse les requêtes automatisées (Access Denied), ce qui a empêché de citer la page officielle du dictionnaire des données ; les colonnes ont été décrites depuis le schéma réel des fichiers.
- taxi_zone_lookup.csvNYC Taxi & Limousine Commission
Table de correspondance des 265 zones de taxi (identifiant, borough, nom de zone, service), vérifiée : 265 lignes. Elle fournit la jointure utilisée dans la requête analytique de l'article, qui relie chaque zone de prise en charge à son arrondissement.
- pandas 3.0.6PyPI
Bibliothèque de comparaison, installée à la version 3.0.6 sur Python 3.12.14 dans un environnement temporaire. C'est la version majeure dont traite l'article Polars publié sur ce blog : le même semestre voit pandas 3.0 et Polars 2.0 changer de version majeure, ce qui rend la comparaison des comportements sous contrainte de mémoire d'autant plus actuelle.
- DuckDB — installationDuckDB
Page d'installation de référence pour la ligne de commande : le binaire autonome se télécharge sous forme d'archive, sans installeur ni privilèges particuliers. C'est la commande utilisée dans la section « Reproduire ce test », avec la version v1.5.6 épinglée pour que les mesures restent comparables.
Chiffres et affirmations vérifiés sur ces sources le .