Laya, un nouveau paquet Python de « décision » qui promet des probabilités calibrées, a été testé ici sur 2 000 critiques de films Allociné, en français, sans réseau et sur un simple processeur. Sans réglage, il se trompe une fois sur cinq et ses probabilités penchent nettement vers le « non ». Recalibré avec 500 exemples étiquetés, il devient très bien calibré, sans rattraper une méthode classique entraînée sur 160 000 critiques. Code, protocole et chiffres complets ci-dessous.
Pourquoi ce test
La veille technologique de ce blog a fait remonter, fin septembre 2026, une petite vague de modèles d'un genre particulier : des modèles qui ne génèrent pas de texte, mais répondent à une question fermée par une probabilité, en une seule passe. Le billet de lancement de JEV-27B, publié sur Hugging Face le 27 septembre, résume bien leur usage : un agent prend beaucoup de petites décisions (« cet e-mail est-il un hameçonnage ? », « quelle équipe doit traiter ce ticket ? »), et ces questions « ne demandent pas un long raisonnement, mais une réponse rapide et calibrée, sur laquelle on peut poser un seuil ».
Laya est la version open source la plus facile à tester de cette idée : pip install laya, des poids publiés sous licence Apache 2.0 sur Hugging Face, et une promesse écrite noir sur blanc dans sa documentation : des probabilités entraînées contre des « règles de score strictement propres », qui auraient donc « un sens statistique ». Pour une data scientist, une promesse de calibration a un avantage rare : elle se vérifie avec les outils les plus classiques du métier.
Qu'est-ce qu'une probabilité calibrée ?
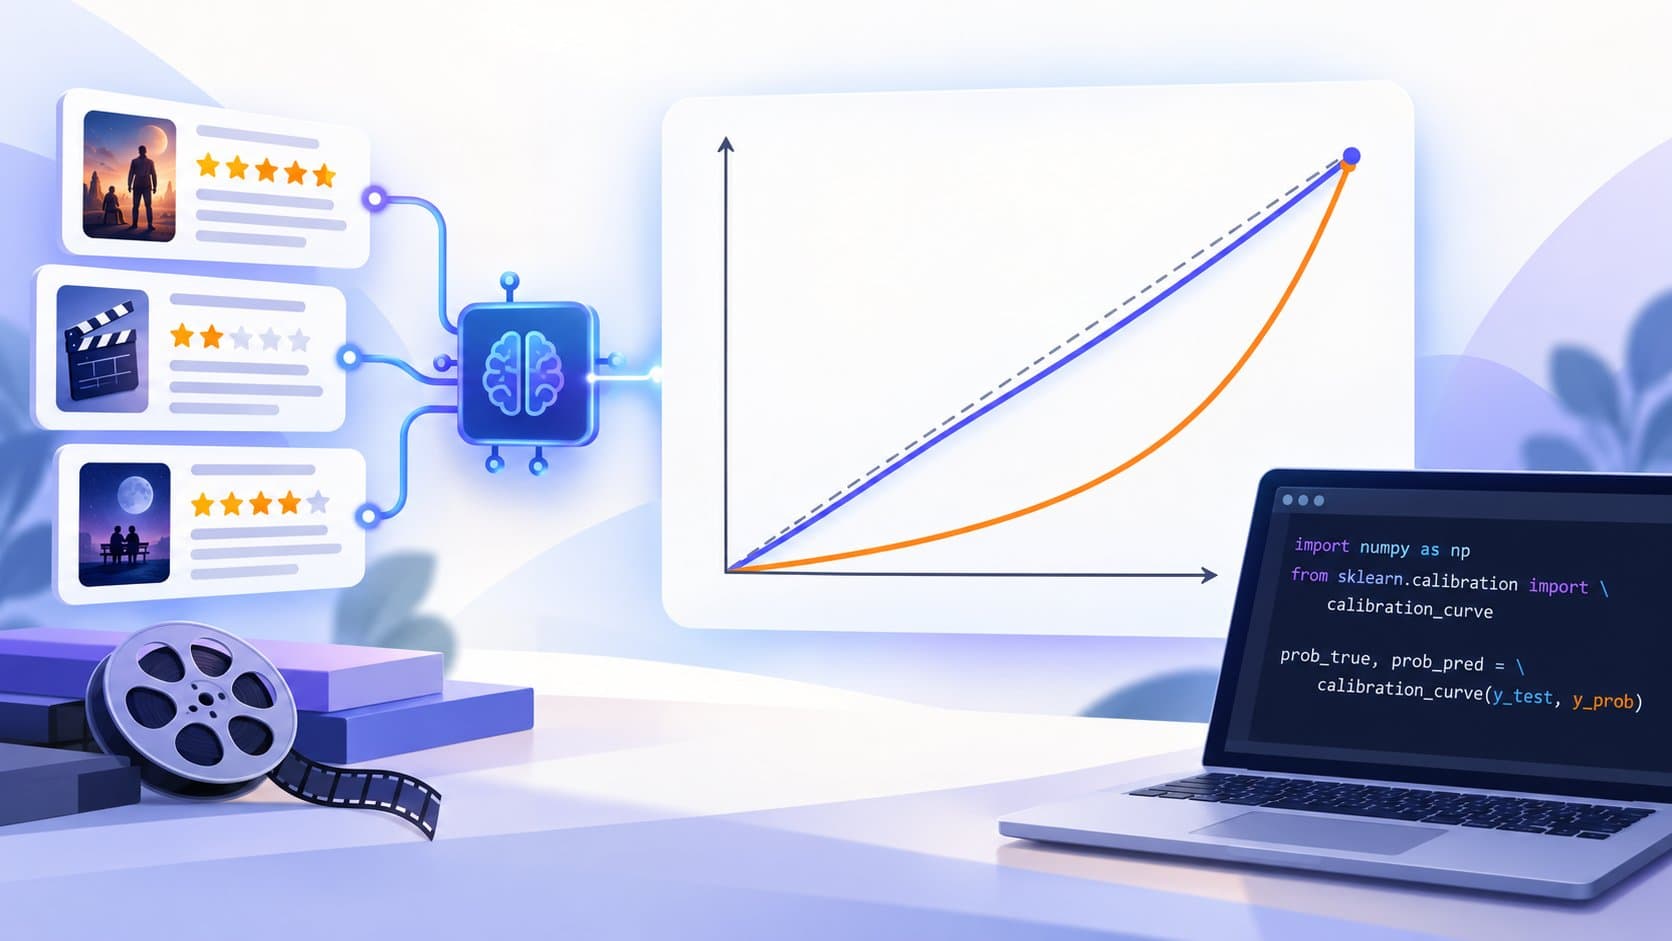
La documentation de scikit-learn en donne la définition la plus simple : un classifieur bien calibré est un classifieur dont les probabilités se lisent comme un niveau de confiance. Parmi les exemples auxquels il donne une probabilité proche de 0,8, environ 80 % doivent réellement appartenir à la classe positive.
Trois mesures servent à le vérifier dans ce test :
- La courbe de calibration (ou diagramme de fiabilité) : on range les prédictions en 10 tranches (0 à 10 %, 10 à 20 %…) et, dans chaque tranche, on compare la probabilité annoncée à la part d'exemples réellement positifs. Un modèle parfaitement calibré suit la diagonale.
- L'ECE (erreur de calibration attendue) : l'écart moyen entre ces deux valeurs, pondéré par le nombre d'exemples de chaque tranche. Plus elle est basse, mieux c'est.
- Le score de Brier : l'écart quadratique moyen entre la probabilité et la réponse (0 ou 1). Il mélange calibration et pouvoir de discrimination : la documentation de scikit-learn précise qu'un score de Brier plus bas ne veut pas forcément dire un modèle mieux calibré. C'est pourquoi il est présenté ici à côté de l'ECE, jamais seul.
Pourquoi est-ce important ? Parce que tout l'intérêt de ces modèles est de poser des seuils : n'automatiser que les décisions prises avec plus de 90 % de confiance, par exemple, et renvoyer les autres à un humain. Avec des probabilités mal calibrées, ce seuil ne veut rien dire.
Le protocole
- Les données : le jeu Allociné (licence MIT), 200 000 critiques de films en français étiquetées positive ou négative. 2 000 critiques ont été tirées au hasard dans le jeu de test (graine 42), dont 47,25 % de positives.
- Laya : version 0.3.21, checkpoint
multilingual, sans aucun entraînement, avec une seule question de type oui/non. - La référence : la méthode classique d'un premier cours de NLP, une pondération TF-IDF des mots et paires de mots suivie d'une régression logistique scikit-learn, entraînée sur les 160 000 critiques d'entraînement.
- L'environnement : un conteneur Docker jetable, sans accès réseau pendant les mesures (modèle et données téléchargés à l'avance, à version figée), 3 processeurs, 5 Go de mémoire, aucune carte graphique.
- Les incertitudes : chaque résultat est donné avec un intervalle de confiance à 95 %, calculé par bootstrap apparié (1 000 rééchantillonnages des mêmes critiques pour les deux méthodes).
L'appel à Laya tient en quelques lignes :
from laya import Router

router = Router()
question = {"positif": {"type": "noul",
                        "instructions": "Cette critique de film est-elle positive ?"}}

reponse = router.predict("Un film ennuyeux, je me suis endormi.", question,
                         model="multilingual")
print(reponse["answers"]["positif"]["noul"])   # 0.1284 : probabilité du « oui »
Le type noul renvoie la probabilité que la réponse soit « oui ». Pour les 2 000 critiques, la méthode predict_batch traite les textes par lots de 8.
Résultat 1 : Laya tel quel se trompe une fois sur cinq
| Sur 2 000 critiques de test | Laya, sans entraînement | TF-IDF + régression logistique (160 000 critiques) |
|---|---|---|
| Bonnes réponses (seuil 0,5) | 79,9 % [78,2 – 81,7] | 94,2 % [93,1 – 95,3] |
| Score de Brier (plus bas = mieux) | 0,154 | 0,053 |
| ECE (plus bas = mieux) | 0,145 | 0,081 |
| AUC (capacité à classer) | 0,914 | 0,985 |
Le détail par tranche montre d'où vient l'écart : Laya penche vers le « non ».
| Probabilité annoncée par Laya | Nombre de critiques | Probabilité moyenne annoncée | Critiques réellement positives |
|---|---|---|---|
| 0 à 10 % | 1 016 | 1,4 % | 13,3 % |
| 10 à 20 % | 125 | 14,4 % | 54,4 % |
| 40 à 50 % | 54 | 45,5 % | 75,9 % |
| 90 à 100 % | 291 | 95,7 % | 95,2 % |
Quand Laya dit « oui » avec assurance, il a raison. Mais il range la moitié des critiques sous les 10 %, alors que 13 % d'entre elles sont positives, et une critique à laquelle il donne 15 % de chances d'être positive l'est en réalité une fois sur deux. Un seuil posé sur ces probabilités laisserait passer beaucoup d'erreurs sans le signaler.
La référence n'est pas parfaite non plus, mais dans l'autre sens : elle est trop prudente. Les critiques auxquelles elle donne environ 35 % sont positives à 12 %, celles à environ 75 % le sont à 93 %. Son ECE reste presque deux fois plus faible que celle de Laya.
Résultat 2 : la méthode de l'auteur corrige peu, celle de Platt corrige presque tout
L'auteur de Laya ne prétend pas que ses probabilités brutes sont parfaites : sa documentation indique qu'il obtient sa meilleure calibration « après ajustement d'une température sur les données du domaine », et conseille de régler ses seuils sur ses propres données. La température est une correction à un seul paramètre, que Guo et ses coauteurs (2017) décrivent comme une variante de la calibration de Platt, « étonnamment efficace » sur la plupart des jeux de données.
Le test a donc été refait comme l'auteur le recommande : Laya a répondu sur 500 critiques du jeu d'entraînement (jamais utilisées dans le test), une température y a été ajustée, puis appliquée aux 2 000 prédictions de test. Seconde variante, pour comparaison : la calibration de Platt, décrite dans la documentation de scikit-learn (méthode sigmoid), qui ajuste deux paramètres, une pente et un décalage.
| Sur les mêmes 2 000 critiques | Bonnes réponses | Brier | ECE |
|---|---|---|---|
| Laya brut | 79,9 % | 0,154 | 0,145 |
| Laya + température (T = 2,08) | 79,9 % | 0,142 | 0,129 |
| Laya + Platt (pente 0,62, décalage +1,00) | 84,1 % [82,5 – 85,7] | 0,115 | 0,023 [0,021 – 0,043] |
| Référence (160 000 critiques) | 94,2 % | 0,053 | 0,081 |
La température change à peine les choses, et ne modifie pas une seule réponse : elle étire les probabilités autour de 50 %, alors que le défaut de Laya est un décalage. Platt, qui ajuste aussi le décalage, le corrige : avec seulement 500 critiques étiquetées, Laya devient mieux calibré que la référence (écart d'ECE de −0,065 à −0,036), tout en restant loin derrière elle pour les bonnes réponses (−11,9 à −8,5 points).
La correction elle-même tient en quelques lignes de scikit-learn :
import numpy as np
from sklearn.linear_model import LogisticRegression

def logit(p):
    p = np.clip(p, 1e-6, 1 - 1e-6)
    return np.log(p / (1 - p))

# p_cal, y_cal : probabilités de Laya et vraies étiquettes sur 500 exemples de calibration
platt = LogisticRegression(C=1e6).fit(logit(p_cal).reshape(-1, 1), y_cal)
p_corrigees = platt.predict_proba(logit(p_test).reshape(-1, 1))[:, 1]
Résultat 3 : à 500 exemples étiquetés, match nul
Comparer Laya recalibré avec 500 étiquettes à une référence qui en a reçu 160 000 n'est pas équitable. La vraie question pratique est différente : si l'on ne dispose que de quelques centaines d'exemples étiquetés, que vaut-il mieux faire ? La référence a donc été réentraînée sur les mêmes 500 critiques, avec deux réglages : les paramètres par défaut, puis une régularisation choisie par validation croisée, pour ne pas l'avantager ni la désavantager.
| 500 critiques étiquetées pour chacun | Bonnes réponses | Brier | ECE |
|---|---|---|---|
| Laya + Platt | 84,1 % | 0,115 | 0,023 |
| TF-IDF + régression logistique, réglages par défaut | 72,6 % | 0,221 | 0,177 |
| TF-IDF + régression logistique, réglée par validation croisée | 83,2 % | 0,125 | 0,076 |
Face à la référence réglée, l'écart de bonnes réponses va de −1,0 à +3,0 points : aucune différence démontrée. En revanche, Laya recalibré reste nettement mieux calibré (écart d'ECE de −0,062 à −0,033). Et la référence mal réglée rappelle un piège classique : avec peu de données, les paramètres par défaut d'un modèle peuvent coûter plus de dix points.
Et la vitesse ?
Sur 3 processeurs, sans carte graphique : 8,8 secondes pour charger le modèle, puis 0,41 seconde par critique en médiane (0,93 s au 95e centile), ou 0,35 seconde par critique en traitant les textes par lots de 8. Les critiques comptaient 129 jetons en médiane. La documentation de Laya annonce 33 millisecondes par question sur une carte graphique T4 : ce chiffre n'est pas comparable à ceux d'un processeur, et n'a pas été vérifié ici. Sur un ordinateur portable, comptez donc plutôt quelques décisions par seconde que quelques dizaines.
Ce que ce test prouve, et ce qu'il ne prouve pas
Il prouve une chose simple : la promesse de probabilités calibrées ne tient pas « à la sortie de la boîte » sur ce cas d'usage, et elle se répare avec quelques centaines d'exemples étiquetés et une correction de deux paramètres. Le modèle classe plutôt bien (AUC de 0,914), c'est sa façon d'exprimer sa confiance qui est décalée.
Il ne prouve pas davantage, pour plusieurs raisons :
- Un seul jeu de données : du sentiment binaire sur des critiques de films. Les tickets, les e-mails ou les décisions à plusieurs options, pour lesquels Laya a été conçu, peuvent donner un tout autre résultat.
- Une seule formulation de la question, en français. Une autre formulation, ou la même en anglais, n'a pas été testée.
- Un seul modèle : le checkpoint
multilingualde base. Son auteur présente une version affinée (laya-typed-decisions) comme nettement meilleure sur ses propres tâches ; elle n'a pas été testée. - Une référence simplifiée : pour tenir en 5 Go de mémoire, la TF-IDF utilise un hachage des mots (220 colonnes) plutôt qu'un vocabulaire exact.
Une leçon de méthode, enfin, que ce test a rappelée en chemin : un premier essai sur 100 critiques donnait à Laya une AUC de 0,984, presque identique à celle de la référence. Sur 2 000 critiques, elle tombe à 0,914. Cent exemples suffisent pour vérifier qu'un script tourne, pas pour juger un modèle.
Faut-il utiliser Laya ?
Oui, dans un cas précis : quand on doit prendre une décision fermée sur du texte, avec peu d'exemples étiquetés, et qu'on a besoin de probabilités exploitables pour poser des seuils. Dans ce cas, à 500 exemples, il fait aussi bien qu'une méthode classique bien réglée, et donne des probabilités nettement plus fiables une fois recalibré.
Non, en revanche, s'il existe déjà des dizaines de milliers d'exemples étiquetés : une TF-IDF et une régression logistique, entraînées en 30 secondes, font bien mieux sur ce test.
Dans tous les cas, la règle est la même que pour n'importe quel modèle : ne pas croire une probabilité sur parole. Tracer la courbe de calibration sur quelques centaines d'exemples de son propre domaine prend une heure et évite de bâtir des seuils sur du sable. C'est l'une des pratiques de contrôle que détaille l'article sur les bonnes pratiques d'une IA responsable en data science.
Reproduire ce test
Les versions utilisées : Python 3.12, laya 0.3.21, PyTorch 2.14.0 (version processeur), transformers 5.17.0, scikit-learn 1.9.1, pandas 3.0.6. Le jeu Allociné se charge directement depuis Hugging Face, en fichiers Parquet, avec pandas (attention aux changements de comportement de pandas 3.0 si vous reprenez un ancien code). Le calcul de l'ECE et de la courbe de calibration, lui, ne demande qu'une dizaine de lignes de NumPy :
import numpy as np

def ece(y, p, nb_tranches=10):
    tranches = np.minimum((p * nb_tranches).astype(int), nb_tranches - 1)
    erreur = 0.0
    for b in range(nb_tranches):
        dans_tranche = tranches == b
        if dans_tranche.any():
            ecart = abs(p[dans_tranche].mean() - y[dans_tranche].mean())
            erreur += dans_tranche.mean() * ecart
    return erreur
Le test principal (2 000 critiques, Laya et référence) a tourné en 13 minutes sur 3 processeurs, le 29 septembre 2026 ; le recalibrage et la comparaison à budget égal ne demandent ensuite que quelques minutes de plus.
Questions fréquentes
Qu'est-ce que Laya ?
Un paquet Python open source (licence Apache 2.0, installable avec pip install laya) qui répond à des questions fermées sur un texte — oui ou non, un choix parmi des options, une note — par une probabilité, en une seule passe et sans générer de texte. Il fait partie d'une famille de modèles dits « System 1 », pensés pour les petites décisions rapides d'un agent : trier un ticket, repérer un hameçonnage, évaluer une urgence.
Qu'est-ce qu'une probabilité calibrée ?
Une probabilité qu'on peut lire comme un niveau de confiance : parmi toutes les prédictions à environ 80 %, environ 80 % doivent être justes. On le vérifie avec une courbe de calibration (probabilité annoncée contre fréquence réellement observée, par tranches) et une mesure d'écart comme l'ECE. Une probabilité calibrée permet de poser des seuils fiables, par exemple n'automatiser que les décisions à plus de 90 % de confiance.
Les probabilités de Laya sont-elles bien calibrées ?
Pas sans réglage, sur ce test : 2 000 critiques de films Allociné, checkpoint multilingual, question « Cette critique de film est-elle positive ? ». Laya penche vers le « non » : il donne moins de 10 % à la moitié des critiques, dont 13 % sont en réalité positives. Son erreur de calibration (ECE 0,145) est presque deux fois plus forte que celle d'une régression logistique classique (0,081).
Comment recalibrer les probabilités d'un modèle comme Laya ?
Avec quelques centaines d'exemples étiquetés de son propre domaine et une calibration de Platt : une régression logistique à une seule variable, le logit de la probabilité du modèle, qui ajuste une pente et un décalage. Sur ce test, 500 critiques ont suffi à faire passer l'ECE de Laya de 0,145 à 0,023. La simple mise à l'échelle par température, recommandée par l'auteur de Laya, n'a presque rien changé ici (0,129), parce que le défaut était un décalage et non un excès de confiance symétrique.
Laya fait-il mieux qu'une régression logistique ?
Cela dépend du nombre d'exemples étiquetés disponibles. Avec 160 000 critiques d'entraînement, une TF-IDF et une régression logistique atteignent 94,2 % de bonnes réponses, contre 84,1 % pour Laya recalibré. Avec seulement 500 exemples de part et d'autre, l'écart d'exactitude n'est pas démontré (−1,0 à +3,0 points), mais Laya recalibré reste nettement mieux calibré (ECE 0,023 contre 0,076).
Laya est-il rapide sans carte graphique ?
Il tourne correctement sur un simple processeur, mais sans atteindre les chiffres annoncés sur carte graphique. Sur 3 processeurs, ce test a mesuré 0,41 seconde par critique en médiane (0,35 seconde en traitant les textes par lots de 8), après 8,8 secondes de chargement du modèle. Sa documentation annonce 33 millisecondes par question sur une carte graphique T4, un chiffre non comparable et non vérifié ici.
Ce résultat vaut-il pour d'autres usages de Laya ?
Pas forcément. Ce test porte sur un seul jeu de données (sentiment binaire de critiques de films), une seule formulation de question en français et un seul checkpoint (multilingual, non affiné). Laya est conçu d'abord pour des tickets, des e-mails et des décisions à plusieurs options, et son auteur présente une version affinée comme bien meilleure. La seule conclusion générale est de méthode : tracer la courbe de calibration sur ses propres données avant de faire confiance à une probabilité.
Sources
- laya · PyPI (documentation de la version 0.3.21)Python Package Index
Documentation officielle du paquet testé : probabilités entraînées contre des règles de score strictement propres (« RLCD »), calibration « statistically meaningful », ECE obtenue « after domain temperature fitting », conseil de valider ses seuils sur ses propres données, et 33 ms par question mesurées sur une carte graphique T4.
- convaiinnovations/layaHugging Face
Dépôt des poids du modèle, sous licence Apache 2.0 (vérifiée sur la fiche du modèle). Le checkpoint multilingual utilisé dans ce test y est publié (révision 55cf4c4e, téléchargée le 29 septembre 2026).
- autotrust/JEV-27B: fast, calibrated decisions and full reasoning from one open modelHugging Face Blog
Billet du 27 septembre 2026 qui décrit l'usage de ces modèles de décision : des questions qui « don't need a long chain of thought » mais « a fast, calibrated answer you can put a threshold on ». Cité pour situer Laya dans cette famille de modèles, pas pour ses propres résultats.
- tblard/allocineHugging Face (Théophile Blard)
Jeu de données de 200 000 critiques de films Allociné en français, étiquetées positive ou négative, sous licence MIT (vérifiée sur la fiche du jeu) : 160 000 pour l'entraînement, 20 000 pour la validation, 20 000 pour le test. Révision a4654f48 utilisée.
- Probability calibration — scikit-learn 1.9.1 documentationscikit-learn
Définition d'un classifieur bien calibré (parmi les prédictions proches de 0,8, environ 80 % positives), courbes de calibration ou « reliability diagrams », calibration de Platt (méthode « sigmoid », pente et décalage) et mise en garde : un score de Brier plus bas ne signifie pas forcément une meilleure calibration.
- On Calibration of Modern Neural NetworksGuo, Pleiss, Sun et Weinberger (arXiv, 2017)
Article de référence sur la mauvaise calibration des réseaux de neurones modernes, qui présente la mise à l'échelle par température comme « a single-parameter variant of Platt Scaling », « surprisingly effective » sur la plupart des jeux de données testés.
Chiffres et affirmations vérifiés sur ces sources le .