L'API Decisions d'OpenAI, ouverte en bêta publique début octobre 2026, a été testée ici sur 2 250 réclamations bancaires réelles à router vers 9 services, puis sur deux contrôles en français. Sans aucun exemple, elle route correctement 81 % des réclamations, autant que son modèle, gpt-6-luna, interrogé par l'API de génération habituelle, mais 5 à 9 fois plus vite et pour environ 5 centimes de dollar les 1 000 décisions. Le revers : sur ce tri, sa confiance affichée est trop optimiste, et aucun seuil ne garantit 95 % de bons routages. Laya, le modèle ouvert testé à ses côtés sur un simple processeur, ne route correctement que 51 % des mêmes réclamations. Protocole, chiffres et code ci-dessous.
Pourquoi ce test
En trois semaines, une nouvelle famille de modèles s'est installée dans le paysage. Le 15 septembre 2026, TypeSafe AI a lancé Jev, présenté comme le premier « System One Model » : « une nouvelle classe de modèles de pointe conçus pour prendre des décisions rapides et structurées, directement utilisables par un logiciel ». Le 1er octobre, Cloudflare a publié Clef, ses propres modèles de décision, en open source sous licence Apache 2.0. Le 7 octobre, Liquid AI a suivi avec d1-3B et d1-omni-600M, pensés pour tourner sur de petits appareils. Entre-temps, OpenAI a ouvert son API Decisions, en bêta publique.
Ce blog avait déjà mesuré l'un de ces modèles, Laya, sur 2 000 critiques de films : un test volontairement simple, une seule question oui/non. Celui-ci va plus loin, avec une question que se posent les équipes qui reçoivent des messages de clients : peut-on confier le tri des réclamations à un modèle de décision, combien cela coûte-t-il, et peut-on se fier à la confiance qu'il affiche ?
Qu'est-ce qu'un modèle de décision ?
Un modèle de langage classique écrit du texte, mot après mot. Un modèle de décision n'écrit rien : on lui donne un texte et une question fermée, il renvoie une réponse typée accompagnée de probabilités. Cloudflare en donne une définition utile : un modèle qui « produit des sorties structurées et bornées, à bas coût, rapidement et de façon constante », à insérer dans un traitement chaque fois qu'une décision est nécessaire. TypeSafe AI résume le compromis : Jev « renonce à la génération de texte ».
L'API d'OpenAI propose trois types de questions :
- le prédicat (
predicate) : une condition est-elle vraie ? La réponse est une probabilité entre 0 et 1 ; - le choix (
choice) : une option parmi une liste que vous fournissez, avec une probabilité pour chaque option ; - la note (
score) : un niveau sur une échelle ordonnée que vous décrivez, par exemple la gravité d'un incident.
Un seul modèle est disponible, gpt-6-luna, sur un point d'accès dédié. La tarification est le second argument : 0,10 dollar par million de jetons en entrée, et rien en sortie, puisque le modèle ne génère aucun texte. OpenAI annonce des réponses « environ 10 fois plus rapides » qu'avec son API de génération habituelle. Ce chiffre fait partie de ce que ce test vérifie.
Un appel tient en quelques lignes de Python, sans bibliothèque à installer :
import json, os, urllib.request

corps = {
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
        "type": "choice",
        "name": "team",
        "instructions": "Which team should handle this consumer complaint?",
        "choices": [
            {"value": "credit_card", "description": "Credit cards: charges, fees, billing disputes."},
            {"value": "bank_account", "description": "Checking or savings accounts."},
        ],
    }],
}
requete = urllib.request.Request(
    "https://api.openai.com/v1/decisions",
    data=json.dumps(corps).encode(),
    headers={"Authorization": "Bearer " + os.environ["OPENAI_API_KEY"],
             "Content-Type": "application/json"})
reponse = json.loads(urllib.request.urlopen(requete).read())["answers"][0]
print(reponse["choice"], reponse["confidence"], reponse["probabilities"])
Le protocole : trois jeux de données, cinq méthodes
Le test principal porte sur des réclamations réelles. Le Bureau américain de protection des consommateurs de produits financiers (CFPB) publie chaque jour les réclamations qu'il transmet aux banques et aux organismes de crédit, librement réutilisables. Chaque réclamation comporte le récit du client, publié sans ses données personnelles, et le produit concerné, que le client a choisi dans un menu au moment du dépôt. Ce test en tire un problème de routage à 9 services : rapports de crédit, recouvrement de dettes, prêt immobilier, carte de crédit, compte bancaire, prêt étudiant, crédit auto, transfert d'argent, prêt personnel.
- Les données : une copie de la base au format Parquet (licence CC0), dont 2 250 réclamations de janvier 2023 à janvier 2024 ont été tirées au hasard, 250 par service (graine 42). Les récits de 200 à 2 000 caractères ont été conservés (729 en médiane), et les lettres types recopiées d'un client à l'autre n'ont été gardées qu'une fois.
- La question : « Which team should handle this consumer complaint? », avec une phrase de description par service. Aucun exemple n'est fourni au modèle.
- Méthode 1, l'API Decisions :
gpt-6-luna, question de typechoice. - Méthode 2, le même modèle « à l'ancienne » :
gpt-6-lunainterrogé par l'API de génération (Responses), qui doit répondre par un petit objet JSON contraint à l'une des 9 valeurs. Deux réglages : le raisonnement par défaut, puis le raisonnement coupé, sa configuration la plus rapide. - Méthode 3, un grand modèle :
gpt-6.1-sol, vingt fois plus cher, sur 450 des 2 250 réclamations. - Méthode 4, la référence classique : une pondération TF-IDF des mots et paires de mots, suivie d'une régression logistique scikit-learn, entraînée sur 5 à 1 663 réclamations étiquetées par service, tirées des années 2021 et 2022. C'est ce qu'une équipe data construirait elle-même.
- Méthode 5, un modèle ouvert sur sa propre machine : Laya 0.4.1, publié la veille du test sous licence Apache 2.0, exécuté sans réseau sur 3 processeurs et sans carte graphique, sans aucun entraînement. Faute de temps de calcul, il n'a traité que 450 des 2 250 réclamations : les mêmes que
gpt-6.1-sol.
Deux contrôles en français complètent le test, parce que les réclamations du CFPB sont en anglais :
- les 2 000 critiques de films Allociné du test de Laya, exactement les mêmes, avec la même question (« Cette critique de film est-elle positive ? ») : de quoi comparer les résultats et mesurer la qualité des probabilités ;
- 1 000 demandes faites à un assistant vocal, tirées du jeu MASSIVE d'Amazon, qui existe en 51 langues traduites par des professionnels : chaque demande est posée une fois en anglais et une fois en français, avec 18 thèmes possibles.
Chaque résultat est donné avec un intervalle de confiance à 95 %, calculé par bootstrap (1 000 rééchantillonnages, appariés quand deux méthodes sont comparées). Les temps de réponse sont mesurés depuis un serveur hébergé en France, avec 8 requêtes en parallèle. L'ensemble a demandé 12 200 appels à l'API et coûté 1,07 dollar.
Résultat 1 : 81 % de bons routages, sans un seul exemple
| Sur 2 250 réclamations, 9 services | Bons routages | Exemples étiquetés nécessaires |
|---|---|---|
API Decisions (gpt-6-luna) | 81,0 % [79,3 – 82,5] | 0 |
gpt-6-luna, API de génération, raisonnement par défaut | 81,2 % [79,5 – 82,8] | 0 |
gpt-6-luna, API de génération, raisonnement coupé | 81,0 % [79,5 – 82,6] | 0 |
| TF-IDF + régression logistique | 79,3 % [77,7 – 80,8] | 14 967 |
Premier enseignement : l'API Decisions ne perd rien en qualité par rapport à gpt-6-luna interrogé par l'API de génération. L'écart entre les deux va de −1,3 à +0,8 point, et les deux API donnent la même réponse pour 92 % des réclamations. Passer à un modèle vingt fois plus cher n'apporte rien non plus : sur les 450 réclamations qui lui ont été soumises, gpt-6.1-sol obtient 84,4 % de bons routages, exactement le score de l'API Decisions sur ces mêmes 450.
Second enseignement : la référence entraînée ne rattrape pas le modèle de décision, même avec près de 15 000 réclamations étiquetées.
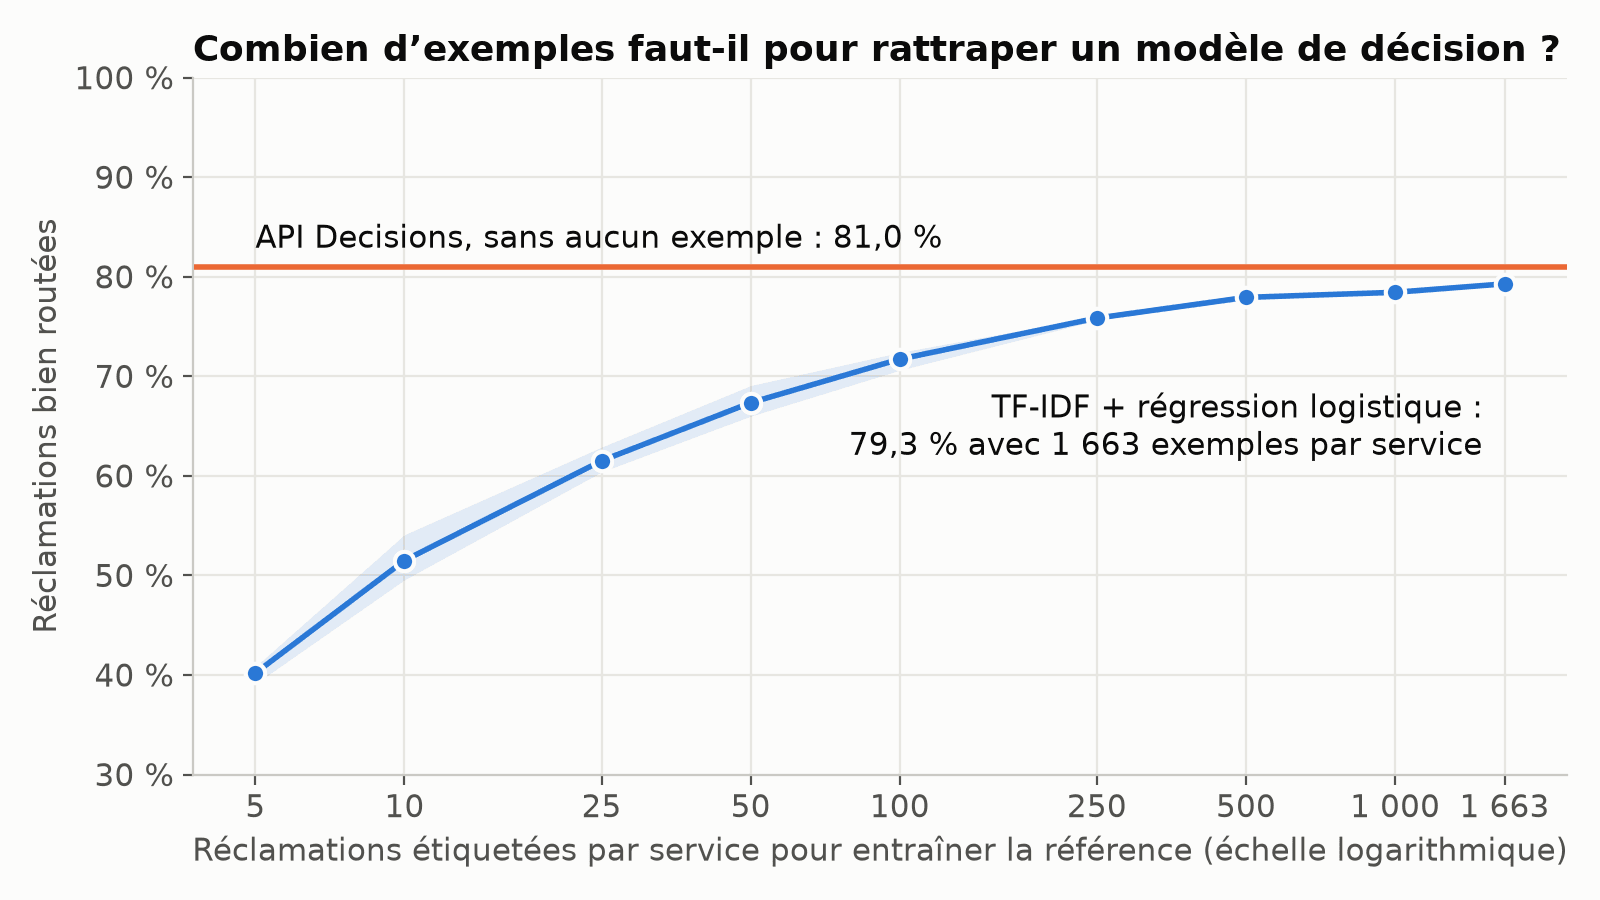
Avec 100 exemples par service (900 réclamations à étiqueter à la main), la régression logistique atteint 71,7 %. Il en faut 500 par service pour approcher 78 %, et la courbe s'aplatit ensuite : 79,3 % avec tout ce que le vivier permettait. L'avantage de l'API Decisions sur cette référence reste mince (0 à +3,3 points), mais il est obtenu sans une minute d'étiquetage.
Tous les services ne se valent pas. L'API retrouve 95 % des réclamations sur les rapports de crédit et 93 % de celles sur les prêts immobiliers, mais seulement 58 % de celles déposées en « recouvrement de dettes ». La raison se lit dans les textes, et elle compte pour la suite.
Une partie des « erreurs » n'en sont pas
La « bonne réponse » de ce test est la case que le client a cochée en déposant sa réclamation. Or un client ne raisonne pas comme un organigramme. Deux exemples, tous deux comptés comme des erreurs de l'API :
« Fair Credit Reporting Act, Section 611 […] you are required to promptly DELETE all information that is inaccurate, incomplete, or which can not be verified. »
Case cochée par le client : crédit auto. Réponse de l'API : rapports de crédit, confiance 1,00.« I would like to dispute the reporting of this bankruptcy on my credit report, as there are discrepancies in the reported dates […] »
Case cochée par le client : recouvrement de dettes. Réponse de l'API : rapports de crédit, confiance 1,00.
Dans les deux cas, le texte parle d'un rapport de crédit, et c'est bien le service qui saurait y répondre. Ce n'est pas un cas isolé : sur les 428 désaccords entre l'API et la case cochée, gpt-6-luna interrogé par l'API de génération donne la même réponse que l'API Decisions dans 77 % des cas, et pour 169 d'entre eux (39 %), les trois méthodes, référence entraînée comprise, s'accordent sur le même autre service. Quand trois méthodes indépendantes lisent la même chose dans un texte, l'étiquette est au moins discutable.
Cela ne transforme pas 81 % en 88 %. Mais c'est un rappel utile avant tout projet de ce genre : la qualité mesurée d'un modèle ne peut pas dépasser celle des étiquettes qui servent à le juger. Sur la répartition réelle des réclamations, où les rapports de crédit pèsent 62 % du volume, la part de bons routages de l'API serait de 88 %, contre 81 % pour la référence.
Résultat 2 : 5 à 9 fois plus rapide, pour le même prix d'entrée
| Par réclamation (471 jetons en moyenne) | Temps médian | 95e centile | Coût pour 1 000 décisions |
|---|---|---|---|
| API Decisions | 0,20 s | 0,49 s | 0,047 $ |
gpt-6-luna, API de génération, raisonnement coupé | 1,07 s | 2,31 s | 0,051 $ |
gpt-6-luna, API de génération, raisonnement par défaut | 1,66 s | 3,89 s | 0,073 $ |
gpt-6.1-sol, génération (450 réclamations) | 2,08 s | 3,72 s | 1,13 $ |
OpenAI annonce des réponses « environ 10 fois plus rapides ». Mesuré d'ici, le rapport est de 5,5 fois face à l'API de génération dans son réglage le plus rapide, et de 8,5 fois face à son réglage par défaut. L'ordre de grandeur est le bon, le chiffre rond un peu flatteur. Concrètement, les 2 250 réclamations ont été triées en 64 secondes par l'API Decisions, contre 6 minutes et 9 minutes et demie pour les deux réglages de l'API de génération.
Côté coût, l'écart entre les deux API est faible à modèle identique, puisque l'essentiel de la facture vient du texte envoyé : la question et ses 9 descriptions ne pèsent qu'une trentaine de jetons de plus qu'une consigne classique. Le vrai gain apparaît face à un grand modèle : 24 fois moins cher que gpt-6.1-sol, pour la même qualité de tri. À 100 000 réclamations par mois, cela fait moins de 5 dollars au lieu de 113. L'ordre de grandeur rejoint ce que montraient déjà le calcul du coût réel d'un agent IA et l'épisode de la guerre des prix de DeepSeek : pour une tâche bien cadrée, le choix du modèle pèse plus lourd sur la facture que le volume.
La référence entraînée, elle, ne coûte presque rien à exécuter et répond en quelques millisecondes. Son coût est ailleurs : dans les milliers de réclamations qu'il a fallu étiqueter, puis dans le modèle à réentraîner chaque fois qu'un service est créé ou renommé. Avec un modèle de décision, ajouter un service revient à ajouter une ligne à la question.
Résultat 3 : une confiance trop optimiste pour automatiser les yeux fermés
Tout l'intérêt d'une probabilité est de pouvoir poser un seuil : router automatiquement les réclamations dont le modèle est sûr, et confier les autres à une personne. Encore faut-il que la confiance affichée dise vrai. La documentation de scikit-learn en donne le critère : parmi les prédictions annoncées à 80 %, environ 80 % doivent être justes.
| Confiance affichée par l'API | Part des réclamations | Routages réellement justes |
|---|---|---|
| 1,00 (maximale) | 63 % | 93,3 % |
| 0,90 ou plus | 86 % | 87,0 % |
| de 0,50 à 0,90 | 13 % | 44 % |
Sur ce tri, l'API est trop sûre d'elle. Elle affiche une confiance de 1,00 pour près de deux réclamations sur trois, alors qu'une sur quinze est mal routée dans ce groupe. Et quand elle annonce 70 %, elle a raison moins d'une fois sur deux. Son erreur de calibration (ECE) atteint 0,143, contre 0,054 pour la régression logistique.
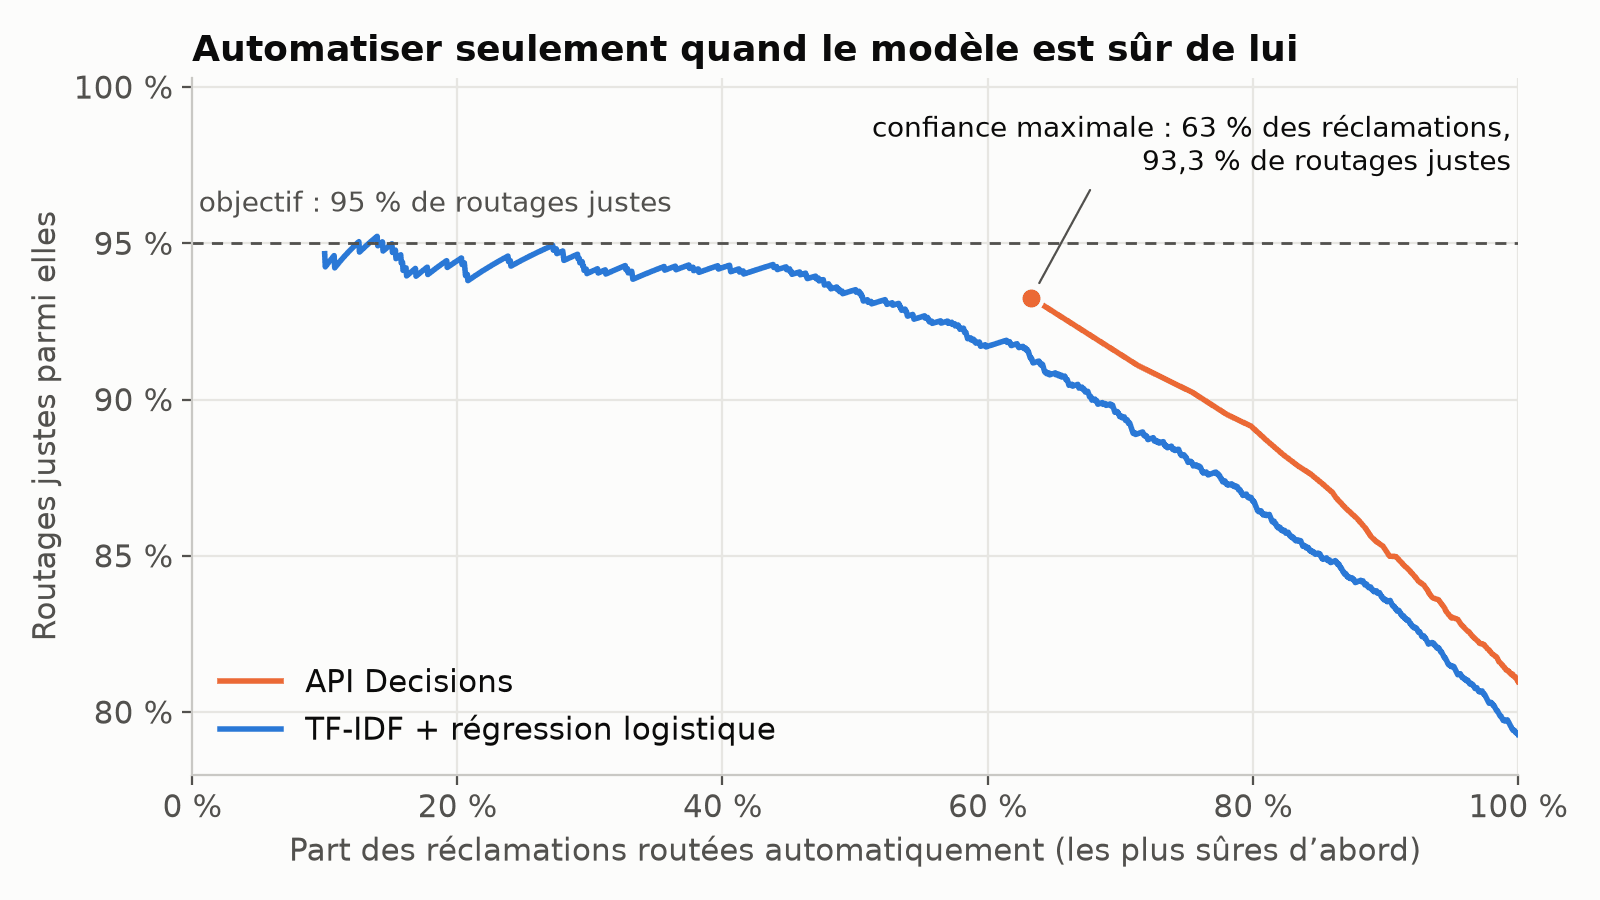
Conséquence pratique : aucun seuil de confiance ne permet d'atteindre 95 % de bons routages avec l'API seule. Le mieux qu'elle offre est 93,3 %, en ne gardant que les 63 % de réclamations à confiance maximale. La référence entraînée, mieux calibrée, y parvient, mais seulement sur 14 % du volume.
À exigence plus modeste, l'avantage revient à l'API : pour 90 % de routages justes, elle peut traiter seule 75 % des réclamations, contre 68 % pour la référence.
Combiner les deux aide, sans faire de miracle. Quand l'API et la référence désignent le même service (81 % des réclamations), le routage est juste dans 89 % des cas ; quand elles divergent, l'API n'a raison qu'une fois sur deux. Un désaccord entre deux méthodes est donc un excellent signal pour demander un avis humain.
Deux réserves s'imposent. La première tient aux étiquettes : une part de cette « sur-confiance » vient des réclamations ambiguës décrites plus haut, où le modèle est sûr de lui et le client a coché autre chose. La seconde : le bon service figure parmi les deux options les plus probables de l'API dans 92,8 % des cas. Proposer deux services à un opérateur plutôt qu'en imposer un est une façon simple d'en tirer parti.
Résultat 4 : en français, le niveau tient
Sur les 2 000 critiques Allociné du précédent test, la question est binaire et les étiquettes sont nettes. Le tableau change.
| Critiques Allociné, en français | Bonnes réponses | ECE (plus bas = mieux) | Exemples étiquetés |
|---|---|---|---|
| API Decisions | 96,9 % [96,1 – 97,6] | 0,012 [0,009 – 0,020] | 0 |
| TF-IDF + régression logistique | 94,3 % | 0,082 | 160 000 |
| Laya 0.4.1, sans entraînement | 80,1 % | 0,143 | 0 |
Ces chiffres portent sur les 1 988 critiques auxquelles l'API a accepté de répondre (voir plus bas) ; en comptant ses 12 refus comme des erreurs, elle reste à 96,3 %. Elle dépasse de 1,4 à 3,7 points une régression logistique entraînée sur 160 000 critiques, et ses probabilités sont cette fois remarquablement bien calibrées : elle range 86 % des critiques sous 5 % ou au-dessus de 95 %, et a raison dans 99,1 % de ces cas.
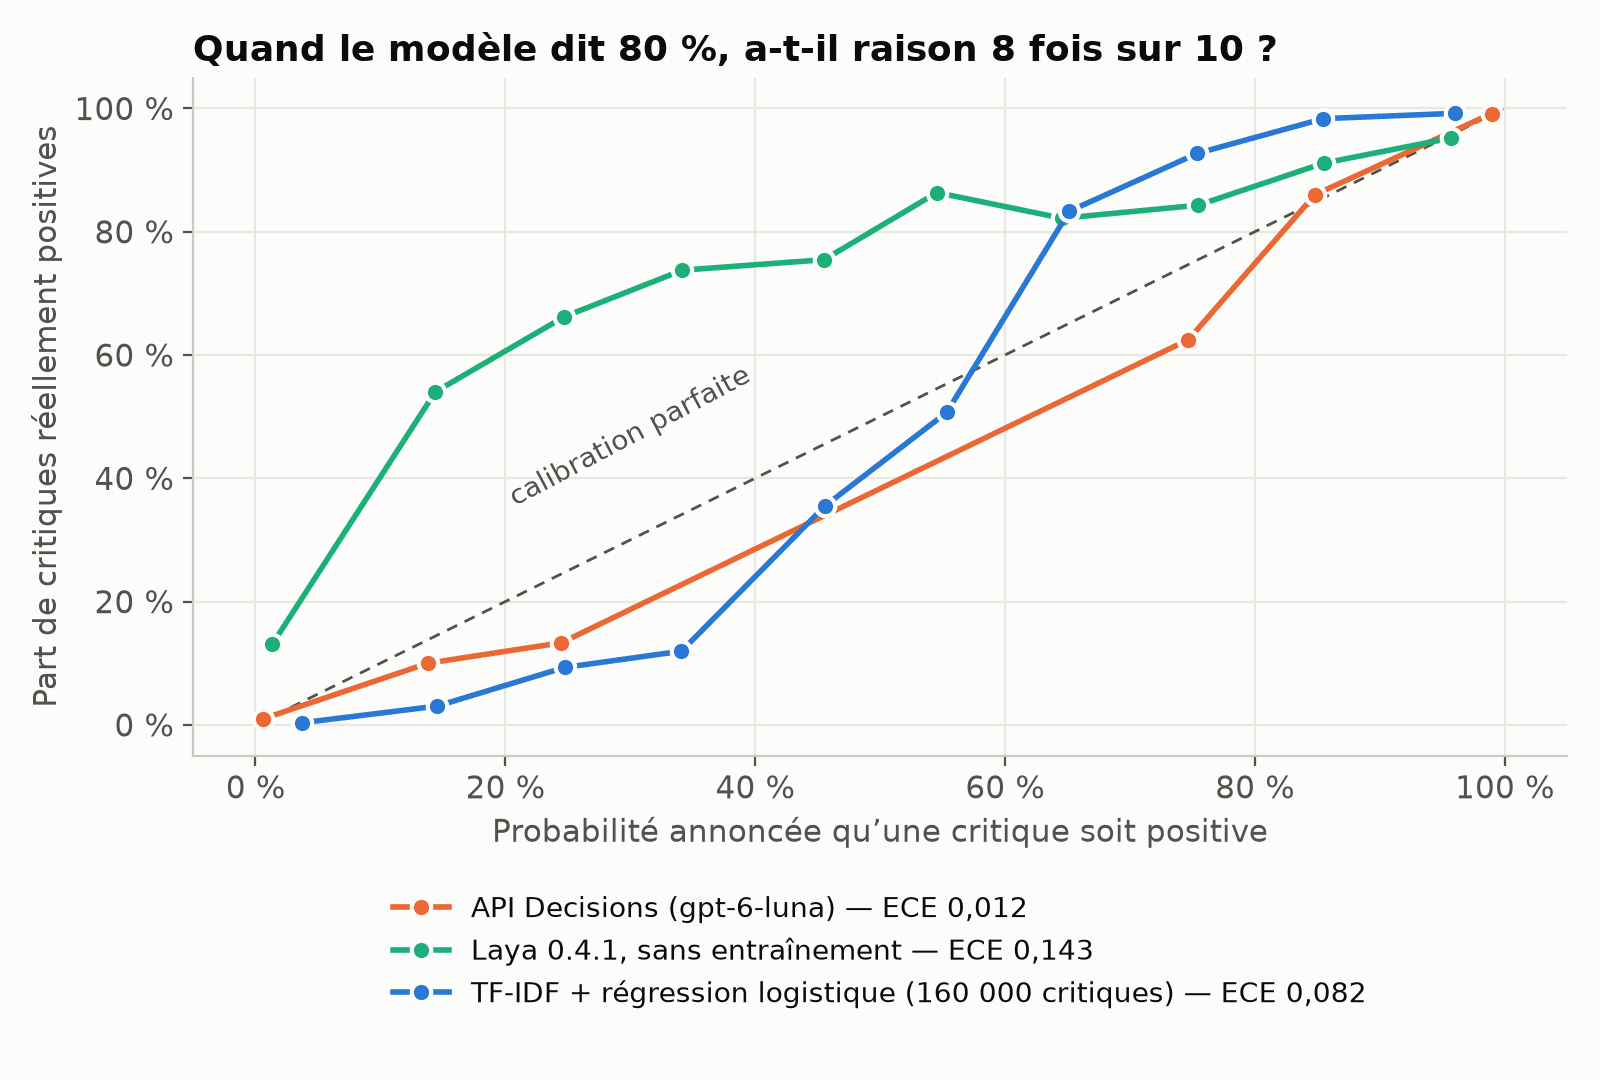
La leçon est la même que pour Laya, en sens inverse : la calibration n'est pas une propriété du modèle, mais du modèle sur une tâche. La même API est fiable sur un sentiment binaire et trop optimiste sur un routage à 9 services aux frontières floues. Seul un échantillon étiqueté de ses propres données permet de le savoir. OpenAI le dit d'ailleurs lui-même : il faut régler ses seuils sur des exemples étiquetés de sa propre application.
Reste la question de la langue. Sur 1 000 demandes posées une fois en anglais et une fois en français, avec 18 thèmes possibles :
| Même demande, 18 thèmes | Bon thème |
|---|---|
| Demande et question en anglais | 83,8 % [81,5 – 86,2] |
| Demande et question en français | 82,9 % [80,5 – 85,3] |
| Demande en français, question en anglais | 83,4 % [81,2 – 85,6] |
L'écart entre le français et l'anglais va de −2,6 à +0,9 point : aucune pénalité démontrée pour le français. Inutile, donc, de rédiger ses questions en anglais pour traiter des textes français.
Résultat 5 : Laya, gratuit et local, mais loin derrière sans entraînement
Reste l'option que beaucoup d'équipes préféreraient : un modèle ouvert, exécuté sur sa propre machine, sans envoyer un seul texte à l'extérieur. Laya est le plus simple à installer (pip install laya) et tient sur un processeur ordinaire. Il a reçu exactement les mêmes textes et les mêmes questions que l'API.
| Mêmes textes, mêmes questions | API Decisions | Laya 0.4.1, sur la machine |
|---|---|---|
| Réclamations bien routées (450, 9 services) | 84,4 % | 50,7 % [46,0 – 55,3] |
| Critiques Allociné, bonnes réponses | 96,9 % | 80,1 % |
| Demandes en anglais, bon thème (500, 18 thèmes) | 83,0 % | 68,0 % [64,0 – 72,0] |
| Les mêmes demandes en français | 81,8 % | 49,0 % [44,6 – 53,4] |
| Temps par réclamation | 0,20 s | 1,95 s (3 processeurs, sans carte graphique) |
| Coût par décision | 0,047 $ les 1 000 | aucun |
| Où vont les textes | chez OpenAI | nulle part |
Sur les réclamations, l'écart est de 29 à 38 points. Laya ne se trompe pas au hasard : il range un tiers des réclamations en « recouvrement de dettes » (145 sur 450, alors que 34 en relevaient), et n'a choisi « prêt personnel » qu'une seule fois, alors que 43 réclamations en relevaient. Sur ces mêmes 450 réclamations, la régression logistique entraînée atteint 82,9 %.
Deux autres enseignements. Le français lui coûte cher : sur les mêmes demandes, il perd 14 à 24 points en passant de l'anglais au français, là où l'API n'en perd aucun de façon mesurable. Et la nouvelle version ne change rien au test précédent : sur les 2 000 critiques Allociné, Laya 0.4.1 renvoie les mêmes probabilités que la version 0.3.21 mesurée le 29 septembre, à la quatrième décimale près, avec le même penchant pour le « non ».
Ce résultat appelle une réserve importante. Laya est testé ici tel qu'il sort de sa boîte, et sa documentation prévient que c'est en l'affinant sur des décisions de son propre domaine que l'exactitude progresse vraiment. Le test précédent l'avait montré à petite échelle : 500 exemples étiquetés suffisaient à corriger ses probabilités. Un Laya affiné sur quelques milliers de réclamations ferait sans doute bien mieux que 51 %, mais il perdrait alors ce qui fait l'attrait d'un modèle de décision : fonctionner sans exemples.
Le détail qui surprend : l'API refuse parfois de répondre
Sur 7 250 décisions demandées, l'API en a refusé 18 : la réponse est alors de type refusal, sans probabilité. Le taux est faible (12 critiques sur 2 000, 3 réclamations sur 2 250, 3 demandes sur 3 000), mais les refus sont stables : les 18 textes, rejoués deux fois, ont été refusés deux fois.
Les textes concernés n'ont rien de choquant. Parmi les critiques refusées : « Nul », « Choquant !!! », ou « excellent, j'ai attrapé un de ces fous rires !! Bon moment de détente ». Beaucoup sont très courts (69 caractères en médiane, contre 387 pour l'ensemble des critiques), mais pas tous. La documentation mentionne ce type de réponse dans ses exemples de code, sans en expliquer les causes.
Pour un usage en production, la conséquence est simple : le code doit prévoir ce cas et renvoyer ces messages vers une personne ou vers une méthode de secours, faute de quoi quelques clients sur mille resteront sans réponse.
Ce que ce test prouve, et ce qu'il ne prouve pas
Ce qu'il établit, dans les conditions décrites :
- sur un tri de réclamations à 9 services, l'API Decisions fait jeu égal avec
gpt-6-lunainterrogé par l'API de génération et avecgpt-6.1-sol, vingt fois plus cher, en répondant 5 à 9 fois plus vite ; - elle fait au moins aussi bien, sans exemple, qu'une méthode classique entraînée sur 15 000 réclamations étiquetées ;
- sa confiance est fiable sur un sentiment binaire, et trop optimiste sur ce routage ;
- le français ne la pénalise pas de façon mesurable ;
- elle refuse de répondre à quelques textes sur mille, de façon répétable ;
- sans entraînement, le modèle ouvert Laya reste 30 points derrière elle sur les réclamations, et perd encore du terrain en français.
Ce qu'il ne dit pas :
- Jev, Clef et d1 ne sont pas comparés. Jev demande un compte chez TypeSafe AI ; Clef pèse 19 Go dans sa plus petite version et ne tient pas dans la mémoire de la machine de test ; d1 n'a pas été mené au bout.
- Laya est testé sans affinage, avec son choix automatique de modèle selon la langue, et sur des échantillons réduits : 450 réclamations et 500 demandes par langue.
- Le type
score(une note sur une échelle) n'est pas testé, pas plus que les images. - Les réclamations sont en anglais, américaines et financières. Le CFPB précise que sa base n'est pas un échantillon statistique de l'expérience des consommateurs.
- La référence est volontairement simple. Un modèle de langue affiné sur les mêmes 15 000 réclamations ferait sans doute mieux qu'une régression logistique.
- L'API est en bêta : ses résultats, ses refus et son prix peuvent changer. Les temps de réponse dépendent du lieu d'appel et de la charge du jour.
- Les probabilités renvoyées sont arrondies à deux décimales, ce qui limite la finesse des seuils possibles.
Faut-il utiliser l'API Decisions ?
Oui, pour trier, router ou filtrer des textes en volume, quand vous n'avez pas d'exemples étiquetés ou que vos catégories changent souvent. Vous obtenez la qualité d'un grand modèle au prix du plus petit, avec un temps de réponse compatible avec une conversation en direct, et une seule ligne à modifier pour ajouter une catégorie.
Oui, mais pas les yeux fermés. Avant d'automatiser quoi que ce soit, étiquetez quelques centaines de vos propres messages et vérifiez ce que vaut la confiance affichée sur votre tâche. Sur les critiques de films, un seuil à 95 % tient ses promesses ; sur les réclamations, il ne les tient pas.
Gardez un modèle classique si vous en avez un. Il coûte moins cher à exécuter, ne dépend d'aucun fournisseur et garde vos données chez vous. Les deux se complètent : leur désaccord désigne précisément les messages à relire.
Trois précautions avant la mise en production : prévoir le cas du refus, garder une personne dans la boucle pour les messages dont la confiance est faible (c'est l'une des bonnes pratiques d'une IA responsable), et se souvenir que vos textes partent chez un prestataire. OpenAI indique proposer un traitement des données en Europe et une option sans conservation pour les clients éligibles ; pour des réclamations de vrais clients, c'est un point à valider avec votre délégué à la protection des données avant le premier appel.
Et si vos textes ne doivent pas sortir de chez vous ? Les modèles ouverts de la même famille (Clef, d1, Laya) sont la seule voie, mais ce test montre qu'il ne faut pas en attendre le niveau de l'API sans travail : comptez un affinage sur vos propres données, ou une machine bien plus puissante pour les plus gros d'entre eux. L'écosystème, lui, avance vite : des extensions permettent déjà d'interroger Jev directement en SQL depuis DuckDB.
Reproduire ce test
Le test tient en cinq scripts Python : préparation des données à graine fixe, appels à l'API (bibliothèque standard seulement), passage de Laya, analyse et figures. Les données, Laya et l'analyse tournent dans un conteneur Docker sans accès réseau ; seul le script d'appels sort sur Internet.
Le cœur de la mesure de confiance, une fois les réponses enregistrées, tient en quelques lignes de pandas :
import pandas as pd

# une ligne par réclamation : service attendu, service choisi, confiance affichée
df["juste"] = df["choix"] == df["label"]
for seuil in (0.90, 0.95, 0.99, 1.00):
    surs = df[df["confiance"] >= seuil]
    print(f"seuil {seuil:.2f} : {len(surs) / len(df):.0%} automatisés, "
          f"{surs['juste'].mean():.1%} de routages justes")
Sur vos propres données, ce tableau à quatre lignes est la première chose à produire : il dit, mieux que n'importe quel benchmark, quelle part de votre flux vous pouvez confier à la machine. Si vous le reprenez dans un projet plus ancien, attention aux changements de comportement de pandas 3.0.
Questions fréquentes
Qu'est-ce qu'un modèle de décision ?
Un modèle d'IA qui ne génère pas de texte : on lui donne un texte (ou une image) et une question fermée, il renvoie une réponse typée accompagnée de probabilités, en une seule passe. Trois types de questions existent : oui ou non, un choix parmi des options, une note sur une échelle. Jev (TypeSafe AI), Clef (Cloudflare), d1 (Liquid AI), Laya et l'API Decisions d'OpenAI appartiennent à cette famille, apparue en septembre 2026.
Qu'est-ce que l'API Decisions d'OpenAI ?
Un point d'accès de l'API d'OpenAI (POST /v1/decisions), en bêta publique en octobre 2026, qui évalue un texte ou une image et renvoie une réponse typée : la probabilité qu'une condition soit vraie (predicate), une option parmi une liste (choice) ou une note sur une échelle ordonnée (score). Un seul modèle est proposé, gpt-6-luna. Elle sert à classer, router ou filtrer des contenus, pas à rédiger.
Combien coûte l'API Decisions ?
0,10 dollar par million de jetons en entrée, et rien en sortie puisqu'aucun texte n'est généré. Dans ce test, une réclamation de 729 caractères en médiane, avec une question à 9 options, pesait 471 jetons en moyenne : 0,047 dollar pour 1 000 décisions, soit moins de 5 dollars pour 100 000 réclamations. Le même tri confié au modèle gpt-6.1-sol coûtait 1,13 dollar les 1 000, pour la même qualité.
L'API Decisions est-elle vraiment 10 fois plus rapide ?
Presque. Mesuré depuis un serveur en France sur 2 250 réclamations, son temps de réponse médian est de 0,20 seconde, contre 1,07 seconde pour son modèle, gpt-6-luna, interrogé par l'API de génération avec le raisonnement coupé (5,5 fois plus lent) et 1,66 seconde avec le raisonnement par défaut (8,5 fois plus lent). OpenAI annonce « environ 10 fois ». La qualité du tri est identique dans les trois cas : 81 % de bons routages.
Peut-on se fier à la confiance renvoyée par l'API Decisions ?
Cela dépend de la tâche, et il faut le vérifier sur ses propres données. Sur un sentiment binaire (2 000 critiques Allociné), ses probabilités sont très bien calibrées : erreur de calibration de 0,012. Sur le routage de réclamations vers 9 services, elle est trop optimiste : une confiance de 1,00 correspond à 93,3 % de routages justes, et aucun seuil ne permet d'atteindre 95 %.
L'API Decisions fonctionne-t-elle bien en français ?
Oui, dans ce test. Sur 1 000 demandes posées une fois en anglais et une fois en français (jeu MASSIVE, 18 thèmes possibles), elle trouve le bon thème dans 83,8 % des cas en anglais et 82,9 % en français : l'écart, de −2,6 à +0,9 point, n'est pas démontré. Sur 2 000 critiques de films en français, elle atteint 96,9 % de bonnes réponses, devant une régression logistique entraînée sur 160 000 critiques.
Faut-il encore entraîner un modèle classique de classification ?
Sans exemples étiquetés, non : sur ce test, une TF-IDF suivie d'une régression logistique n'atteint que 71,7 % de bons routages avec 100 exemples par service, et 79,3 % avec près de 15 000 réclamations étiquetées, contre 81,0 % pour l'API sans aucun exemple. Un modèle classique garde trois atouts : il ne coûte presque rien à exécuter, garde les données chez vous, et son désaccord avec l'API signale les messages à faire relire.
Que se passe-t-il quand l'API Decisions refuse de répondre ?
Elle renvoie une réponse de type refusal, sans probabilité. Dans ce test, 18 décisions sur 7 250 ont été refusées (12 critiques de films, 3 réclamations, 3 demandes à un assistant), et les 18 l'ont été de nouveau à chaque nouvel essai. Les textes concernés étaient anodins, souvent très courts (« Nul », « Choquant !!! »). Le code qui appelle l'API doit donc prévoir ce cas et renvoyer ces messages vers une personne.
Un modèle de décision open source comme Laya peut-il remplacer l'API Decisions ?
Pas sans travail, d'après ce test. Exécuté sur un simple processeur et sans entraînement, Laya 0.4.1 route correctement 50,7 % de 450 réclamations, contre 84,4 % pour l'API sur les mêmes, et met 1,95 seconde par réclamation contre 0,20. Il perd aussi 14 à 24 points en passant de l'anglais au français. Ses atouts sont ailleurs : aucun coût par appel et des textes qui ne quittent pas la machine. Sa documentation recommande de l'affiner sur ses propres données.
Jev, Clef, d1, Laya : quelles sont les alternatives à l'API d'OpenAI ?
Jev, de TypeSafe AI, est le modèle qui a lancé la catégorie le 15 septembre 2026 ; il est accessible par API à 0,042 dollar par million de jetons. Clef (Cloudflare, licence Apache 2.0), d1 (Liquid AI) et Laya (Apache 2.0) publient leurs poids et peuvent tourner sur vos propres machines, ce qui évite d'envoyer vos textes à un prestataire. Dans ce test, seul Laya a été comparé à l'API d'OpenAI ; Jev, Clef et d1 ne l'ont pas été.
Sources
- Decisions — OpenAI API (guide officiel)OpenAI
Documentation de l'API testée : statut « public beta », modèle gpt-6-luna et point d'accès POST /v1/decisions, trois types de questions (predicate, choice, score), réponses annoncées « about 10x faster than the Responses API », conseil de régler ses seuils sur des exemples étiquetés de sa propre application, et traitement des données en Europe pour les clients éligibles.
- Introducing System One Models & JevTypeSafe AI
Billet de lancement du 15 septembre 2026, signé du fondateur Diogo Almeida : « a new class of frontier models built to make fast, structured decisions that software can use directly », un modèle qui « gives up string generation », facturé 0,042 dollar par million de jetons en entrée, sortie gratuite.
- Introducing Clef: our open-source decision models, and new RL fine-tuning platformCloudflare
Billet du 1er octobre 2026 : définition d'un modèle de décision (« a model that produces bounded structured outputs cheaply, quickly and consistently »), modèles Clef et Clef-Flash publiés sur Hugging Face « under an Apache 2.0 license ».
- Open d1: Edge decision models for text, vision, and audioLiquid AI
Annonce du 7 octobre 2026 de d1-3B et d1-omni-600M, deux modèles de décision à poids ouverts qui « don’t produce tokens » et répondent « in a single forward pass », avec des temps mesurés sur des cartes embarquées.
- Pricing — OpenAI APIOpenAI
Grille tarifaire lue le 9 octobre 2026, niveau Standard, en dollars par million de jetons : gpt-6-luna à 0,10 en entrée et 0,50 en sortie, gpt-6.1-sol à 2,00 en entrée et 10,00 en sortie. Le guide de l'API Decisions précise que seuls les jetons d'entrée y sont facturés.
- Consumer Complaint DatabaseConsumer Financial Protection Bureau (CFPB)
Base publique des réclamations transmises aux établissements financiers américains, mise à jour quotidiennement et librement réutilisable. Le CFPB y précise qu'elle n'est pas un échantillon statistique de l'expérience des consommateurs ; sa page sur l'usage des données indique que les informations personnelles (noms, coordonnées, numéros de compte) ne sont pas publiées.
- BEE-spoke-data/consumer-finance-complaintsHugging Face
Copie de la base du CFPB au format Parquet, sous licence CC0 (vérifiée sur la fiche du jeu), utilisée pour ce test : fichier has-text/train-00002-of-00003, 563 191 réclamations avec récit de mars 2015 à janvier 2024, révision 088cc730.
- tblard/allocineHugging Face (Théophile Blard)
Jeu de 200 000 critiques de films Allociné en français, étiquetées positive ou négative, sous licence MIT. Les 2 000 critiques de test utilisées ici sont celles du test de Laya du 29 septembre 2026 (révision a4654f48, graine 42).
- MASSIVE: A 1M-Example Multilingual Natural Language Understanding Dataset with 51 Typologically-Diverse LanguagesFitzGerald et al., Amazon (arXiv, 2022)
Article de présentation du jeu MASSIVE : « 1M realistic, parallel, labeled virtual assistant utterances spanning 51 languages, 18 domains, 60 intents », obtenu en confiant à des traducteurs professionnels la localisation du jeu anglais SLURP. Les mêmes 1 000 demandes de test sont utilisées ici en français et en anglais.
- Probability calibration — scikit-learn documentationscikit-learn
Définition d'un classifieur bien calibré (parmi les prédictions proches de 0,8, environ 80 % positives) et courbes de calibration, sur lesquelles reposent les mesures de confiance et l'erreur de calibration (ECE) de ce test.
- laya · PyPI (documentation de la version 0.4.1)Python Package Index
Paquet testé, version 0.4.1 publiée le 8 octobre 2026 sous licence Apache 2.0 : moteur de décision multilingue « in a single forward pass », avec « a router that picks the right checkpoint per request ». La documentation précise que « the shipped checkpoints work zero-shot, but fine-tuning on decisions from your own domain is where accuracy jumps ».
Chiffres et affirmations vérifiés sur ces sources le .